
目前把以前大學做的魔術方塊專題又整理了一次。以前是用 C# 和 Unity,照 8355 法去找解法,再把轉動過程畫出來。2024 年寫過一篇 mstc dqn cube,那時候想試試看讓 ChatGPT 幫忙重寫,再加上機器學習,看能不能自己學會怎麼轉。
不過這次回頭看,先遇到的問題還不是模型太小,是方塊有沒有真的轉對、老師給的答案有沒有真的解完。這邊如果錯了,後面 GPU 跑再久,學到的也是錯的東西 xd
這篇把這次整理的過程記下來。後面的訓練比較表來自 2026 年 9 月 5 日的實驗紀錄,當時小模型加 MCTS 在打亂 6 手的 1,000 題測試解出 972 題;比較深的盤面還沒有過關。下面的還原圖則是這次補圖時,用目前本機權重重新執行的一個案例。
先看一個實際還原的案例
先放這次實際跑出來的一個成功案例,看圖比較快。把完成的方塊打亂 R U F' L D B',再把當下的 54 格交給模型加 MCTS,模型解出的路徑是 B D' L' F U' R',剛好 6 步轉回來。
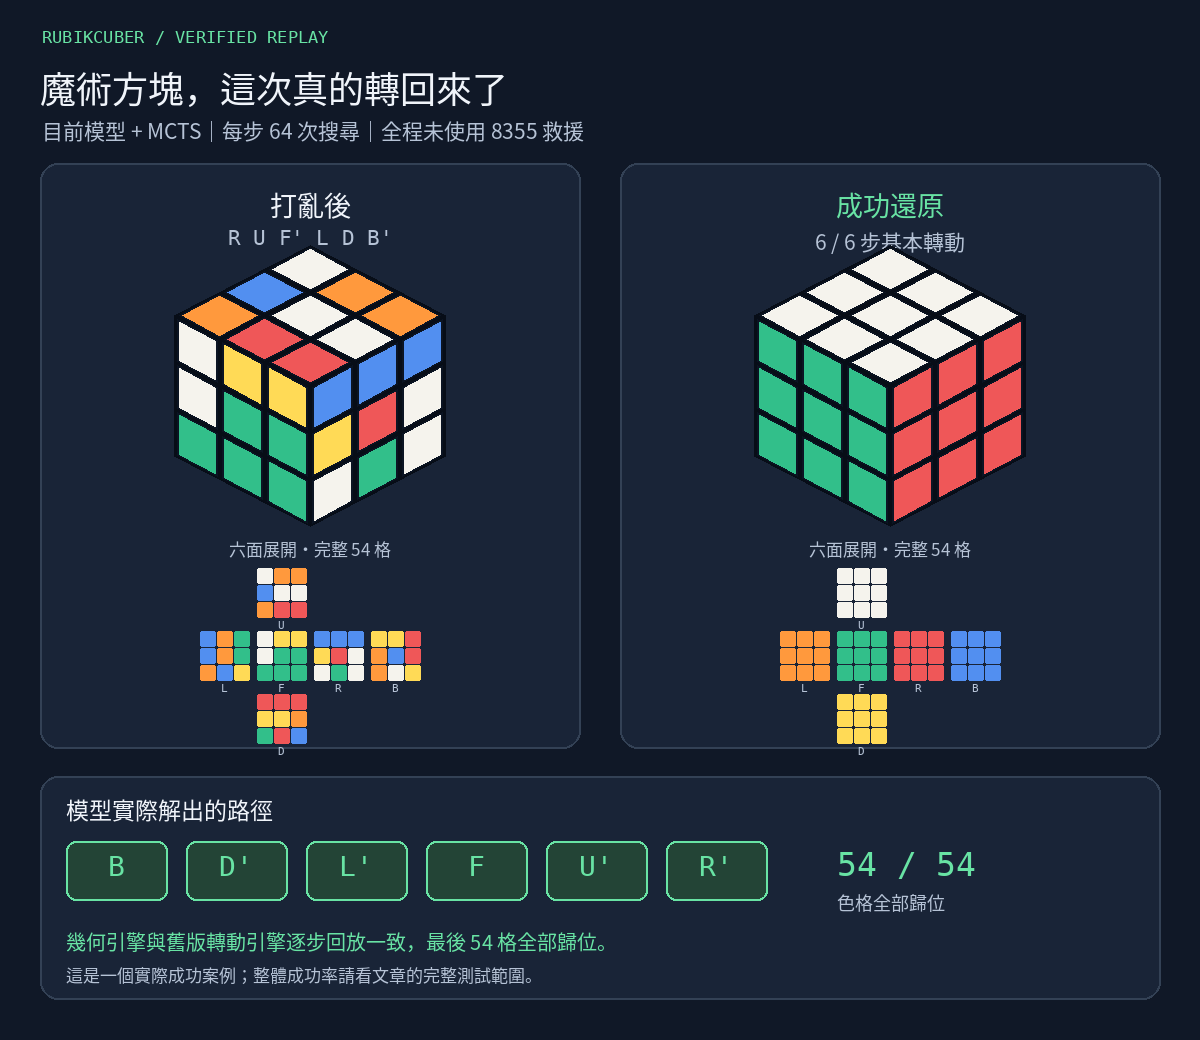
左邊是打亂後,右邊是解完;底下把背面看不到的顏色也攤開,六面都可以對照。這次每步用 64 次 MCTS simulation,全程沒有開 8355 救援,也沒有把打亂歷史交給模型。最後用幾何引擎和移植的舊版轉動引擎,從原盤面逐步重播模型的答案,每一步都一致,54 格全部歸位。
展開看 6 步的實際回放動畫
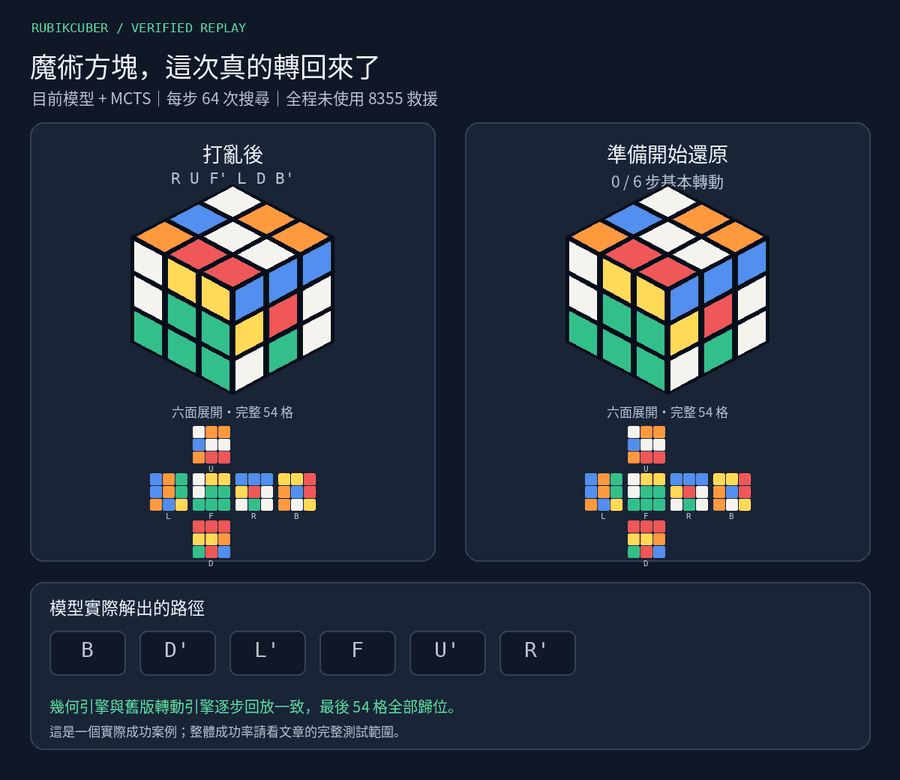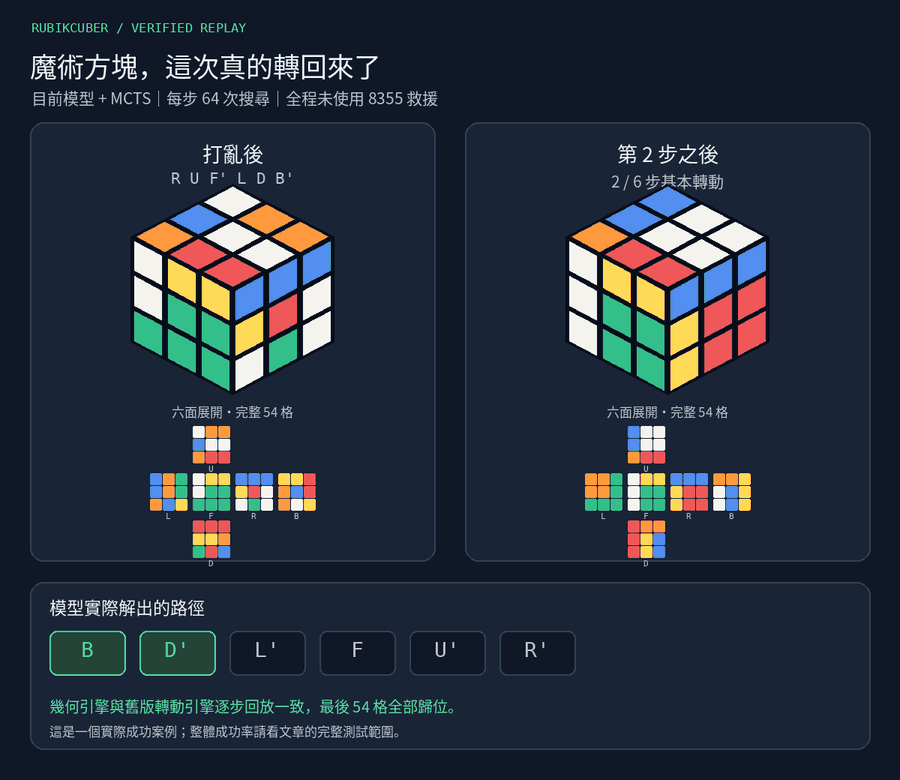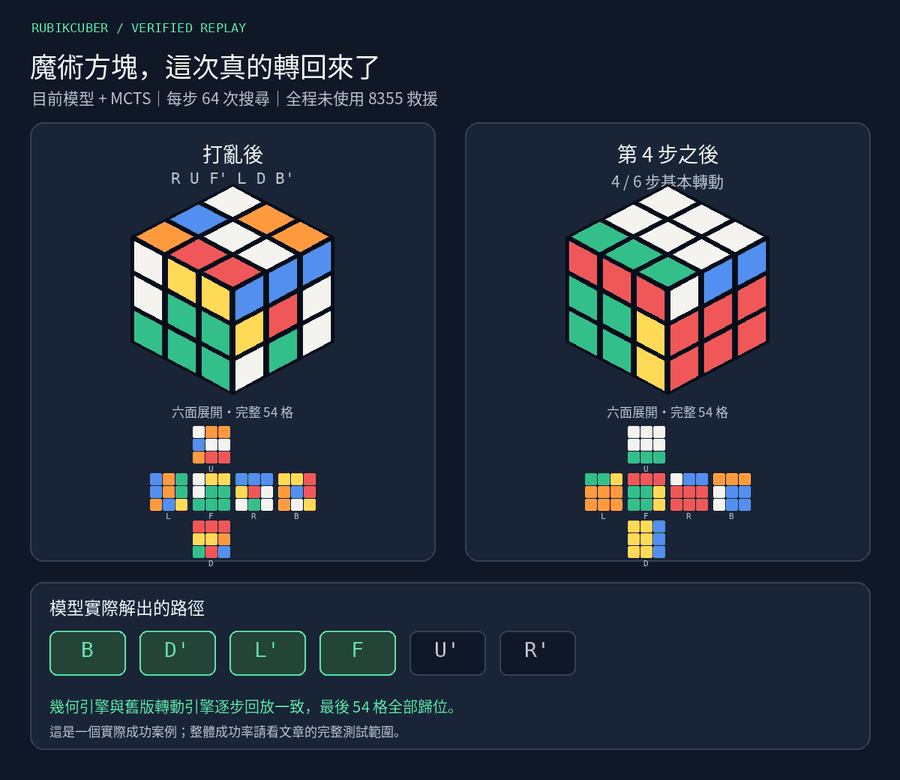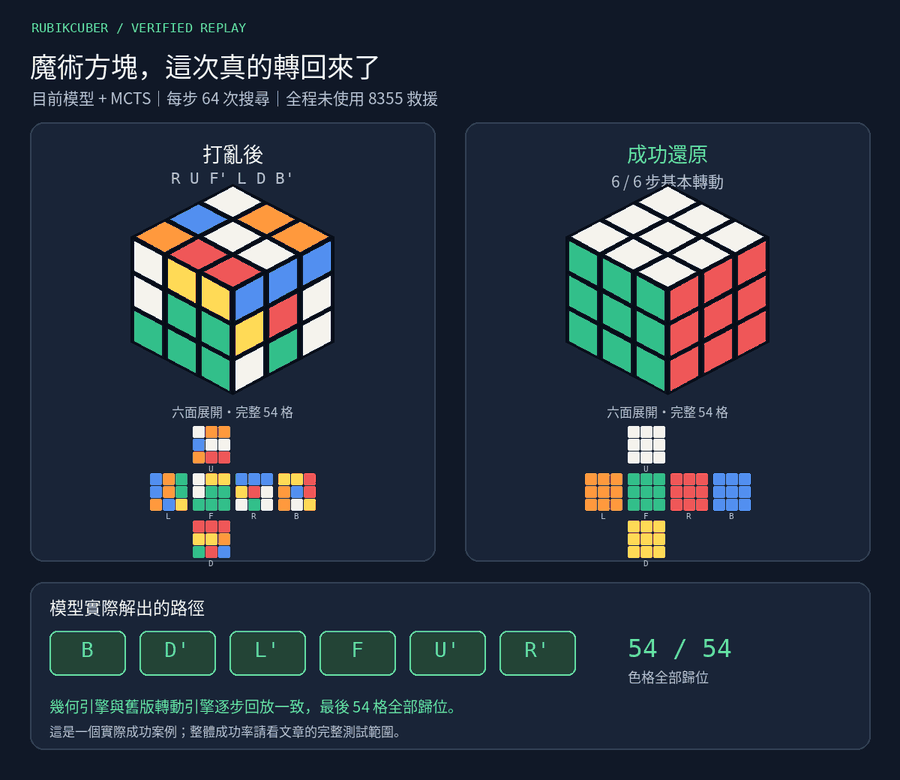
這是一個成功展示,整體成功率還是要看後面的完整測試範圍。這一題的動作、每一步 54 格狀態和權重 SHA-256 也一起留下來。
先把以前的方塊轉對
原本的 Unity 專題是把魔術方塊攤成二維陣列,轉一面就去搬對應位置的顏色。以前手寫這些位置,看畫面好像有轉回來,不一定代表內部陣列也對。
這次用 54 個不同的編號追蹤,才發現舊 C# 的 F、B、L、R 有些逆時針分支,跟順時針不是互相抵銷的。也就是你轉一下再轉回來,資料可能已經變了。
Python 的方塊環境改用整數 3D 幾何產生轉動對應表,再檢查正轉加反轉會歸零、同一面轉四次會歸零。移植的舊解法也要和這套幾何引擎互相比對,最後把整條答案重新播一次,確認 54 格全部回到完成狀態。
這邊還抓到一個很短的反例:
U' F R
只有三手,但舊程式在最後五邊只看了部分貼紙,就以為做完了。最後五角也有類似的漏況。所以這次不能只相信某個 final_check() 回傳成功,要讓整顆方塊自己證明答案有用。
8355 先當一個能驗證的老師
8355 在這個專題裡,大致是分成下面四段:
8 個底層塊 → 3 個中層邊 → 剩下 5 個邊 → 最後 5 個角
工作區留給後面的交換使用。原本 C# 裡面的找塊、換塊流程保留下來,另外補上漏掉的分支,把可能一直跑的遞迴和迴圈加上上限。碰到沒處理到的盤面就帶反例報錯,不能直接當完成。
之前的驗證紀錄是 40,000 組各打亂 50 手,加上 10,000 組直接抽樣的合法 cubie 狀態,確定性 8355 求解器都沒有失敗。這是在測傳統解法,不能把這 50,000 題算成神經網路的成績,也不代表有限測試就證明所有盤面都沒問題。
老師先可靠,才有辦法拿它產生教材。不然模型明明照答案做,方塊卻沒有解開,根本不知道要怪誰。
DQN 有跑,不代表學會了
一開始很直覺,給模型盤面,讓它選一個轉法,慢慢把 reward 拉高。不過 loss 下降跟真的能解開,中間還差很多。
舊研究版補了 Double DQN、target network、合法動作 mask,也讓狀態包含現在的 8355 階段和上一手。顏色用 one-hot,避免把色號 0 到 5 當成有大小關係的數值。公式如果實際包含好幾手,折扣也要照真正的手數算。
後來 v3 另外開一條路,沒有接著訓練舊的 DQN 權重。改成一個 policy/value 小模型,只看現在的 54 格,輸出下一手的機率和預估剩餘距離。每一個中途盤面都重新請 8355 規劃第一手,不把舊程式的 phase、counter 偷偷當成模型知道的事。
這個模型預設 416,655 個參數,14 個基本轉動動作,包含 E 中層轉動,沒有把一整串公式算成一手。FP32 權重約 1.6 MB,當時匯出的 INT8 TorchScript 是 500,777 bytes,約 489 KiB。
先學短的,再讓搜尋幫忙
只拿 8355 的長答案去學,模型很容易學得像老師,卻不會自己收尾。那次 training loss 一直降,但打亂 1~50 手的純模型完整解題成功率只有 2%,這樣不能算收斂。
所以後來混入 reverse curriculum。從完成狀態轉出去,反向路徑就可以當短解教材,先學接近完成的盤面,再逐步增加打亂長度。模型推論時仍然只看當前盤面,不會拿到產生測試題的打亂歷史。
接著讓 MCTS 用 policy 決定先往哪裡找,再用 value 估計後面還有多遠。這次有樹、有節點統計,也有每一步的 simulation 預算;不是隨機多轉幾次就叫 MCTS。
如果模型走錯,會走到教材沒出現的盤面,再把這些失敗案例收回來補資料,這就是這邊用 DAgger 的原因。不過補資料也不是一定會變好,之前有一輪新增 6,466 個去重狀態,微調後沒有超過原本的 checkpoint,就沒有拿它蓋掉比較好的版本。
到底解得怎樣
下面每一列的題目範圍不同,不能把它們接起來當成同一場測試的成長曲線。
| 方法與測試範圍 | 結果 | 怎麼看 |
|---|---|---|
| 只用靜態 8355 教材;打亂 1~50 手;純模型 | 成功率 2% | loss 下降,完整解題仍然失敗 |
| 加入短路徑教材;未見的打亂 1~12 手,共 200 題;greedy | 最佳 55.5% | 已經能學到短解,但還不穩定 |
| MCTS;混合打亂深度,共 100 題;每步 64 次 simulation,上限 50 步 | 最佳 66%;成功題平均 4.61 步 | 同組題由 65% 改善到 66%,深的題還有明顯缺口 |
| 後續 CUDA 驗收;全部打亂 6 手,共 1,000 題;上限 50 步 | 97.2%(972/1000);成功題平均 5.86 步 | 失敗以 50 步計入後,平均是 7.096 步 |
最後一列的舊紀錄沒有完整附上 seed 和 simulation 設定,所以保留當時結果,不能把別列的設定直接補上去。這些數字也沒有綁定公開的權重雜湊,不能保證本機後來的 checkpoint 就是產生該列結果的那一份。
打亂 6 手是產生題目的方式,不代表每題的最短解一定是 6 手。另一個要分清楚的是,成功題平均 5.86 步只算那 972 題;同批 8355 平均 211.91 步算的是全部 1,000 題。看起來差很多,但不能直接拿兩個平均宣稱快了幾十倍,步數也不是執行時間。
兩邊的計數方式也還沒有統一:8355 計的是輸出記號數,像 U2 算一個記號;模型每一步則是一個 90 度基本轉動。因此這些步數先用來觀察各自的行為,不能直接當成嚴格的效率排名。
目前最明顯的問題是深度。那組 100 題的紀錄裡,打亂 1~5 手可以全解,11~12 手是 0%。所以還不能說「魔術方塊 AI 完成了」,只能說在短路徑上已經有實際進步。
真正要用的時候,保留兩種模式
研究模式就讓模型加 MCTS 自己解,失敗算失敗,不能偷偷請 8355 救援再算成功。
實際使用可以另外開 --fallback-teacher。先比較純 8355 的答案,和「模型走一段,再接 8355」的答案,最後選比較短、而且完整回放通過的那條。這樣可以保留學習模型找到短路徑的機會,也能在求解器成功回傳時,檢查答案確實可用。
下一步會先補打亂 6 手還會失敗的案例,再往更深的題走。驗收方式也固定下來:每個打亂深度至少三組不同的 seed,每組 1,000 題,不開 fallback 都要達到 99%,再看把失敗算進去的平均步數。模型變大、loss 變漂亮,都不能代替這一關。
這次重寫比較有感的地方,是終於能分清楚「方塊轉錯了」、「老師沒解完」和「模型還沒學會」。先知道問題在哪一層,後面才有辦法繼續改。
專案過程和各版本差異另外整理成 English README。目前公開倉庫保留原本的 Unity/C# 程式與這份說明,Python AI 實驗程式、訓練資料和權重還在本機,文章中的歷史成績也一併保留適用範圍。
Comments