
傾向性分析
JOSPON-with-Pytorch 在這個github中他提供的範例,可以直接顯示評價是接近於正面還是負面 流程大概如下
- 先處理wiki data,準備製作w2v模型
- 使用檔案:w2v_seg.py
- 使用處理好的wiki data訓練w2v模型
- 使用檔案:w2v_train.py
- 取得waimai資料集句向量,製作waimai_10k_tw.pkl
- 使用檔案:make_w2v_set.py
- 訓練神經網路
- 使用檔案:jwp_train_bce.py
- 測試
- 使用檔案:demo.py
一般直接clone下來可能會發現什麼叫做處理好的wiki data 這邊的意思是假設自己要訓練自己的模型的話,可能就是把想要分析的資料存到
wiki_zh_tw.txt
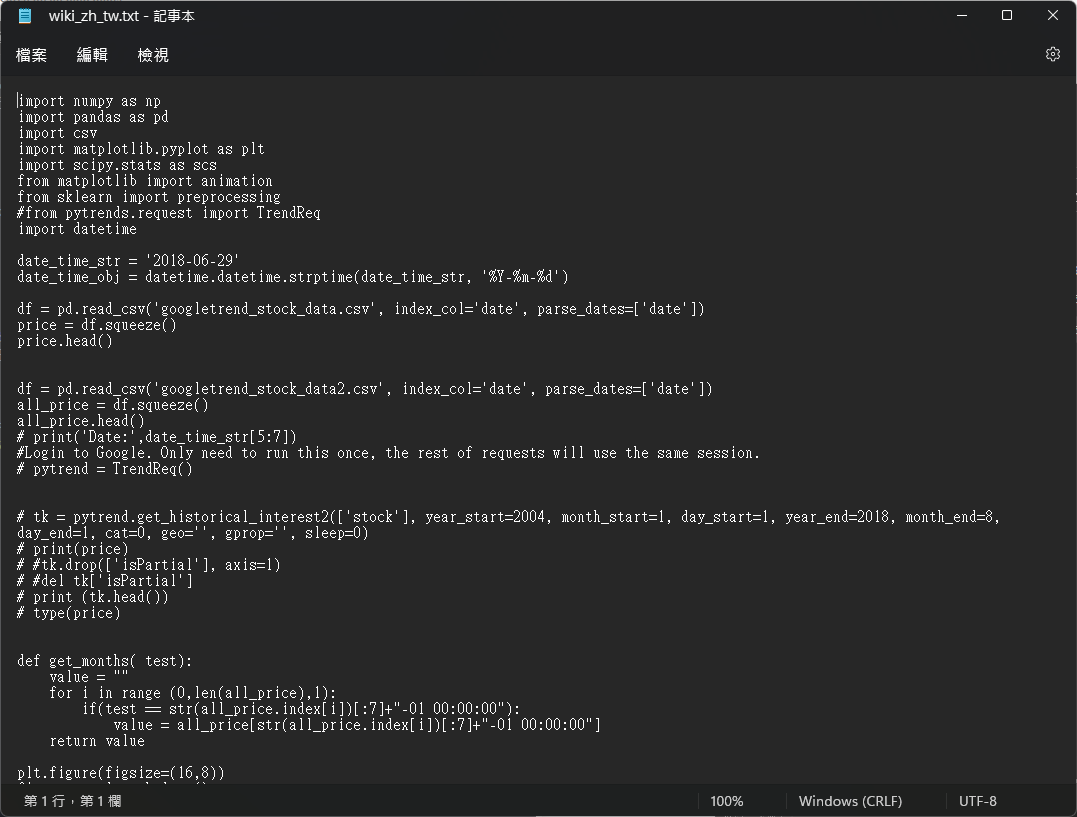
那麼執行w2v_seg.py 則會在得到已經經過Jieba 段詞後的檔案 https://ithelp.ithome.com.tw/articles/10258894
wiki_seg.txt
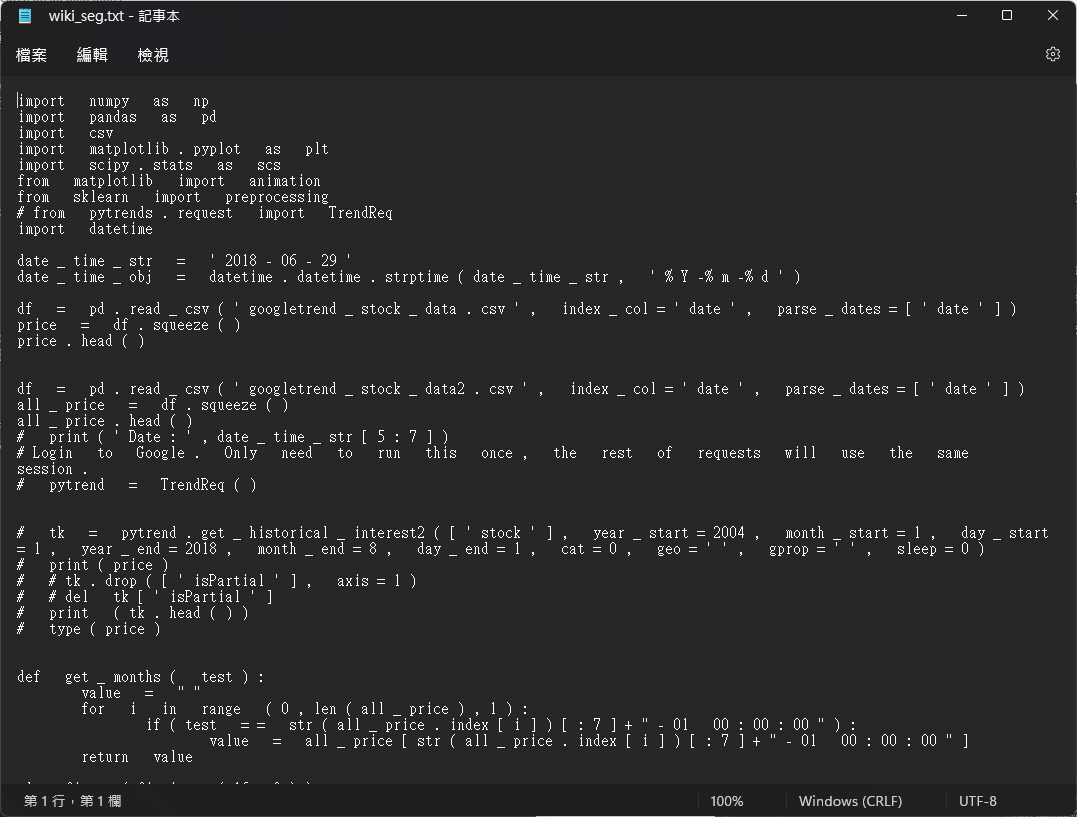
此時我們將會把要訓練的檔案透過
w2v_train.py
轉為pkl
以他的github的例子是
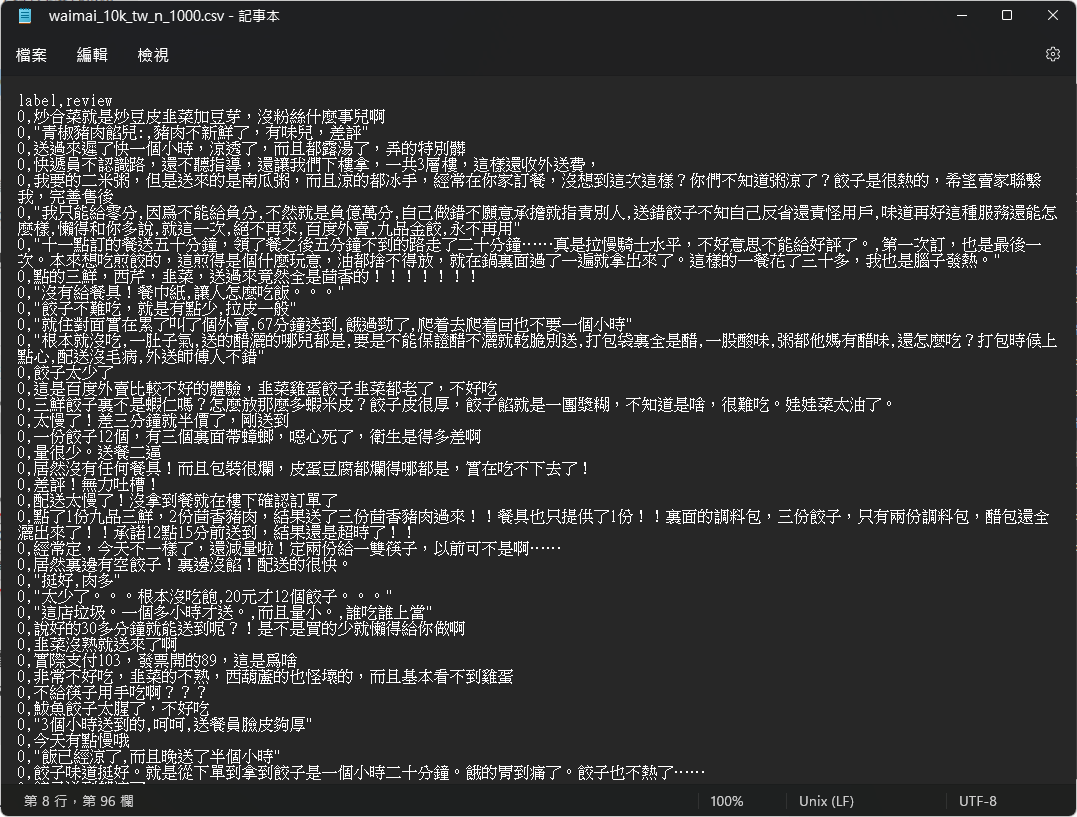 可以發現裡面就是 相對應的句子對應正面或負面 (1/0)
所以輸出的話會是一個機率的樣式
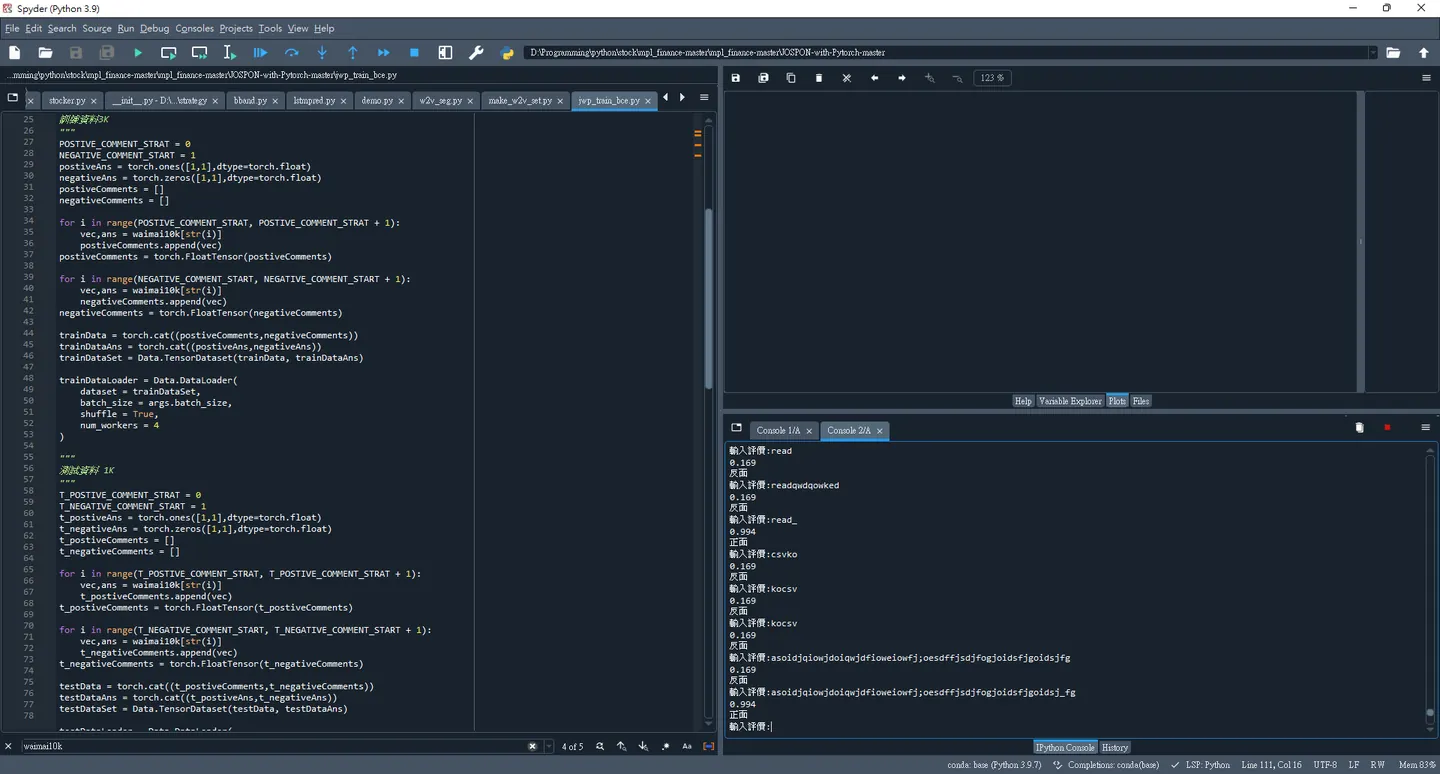
那麼我們隨便寫一下
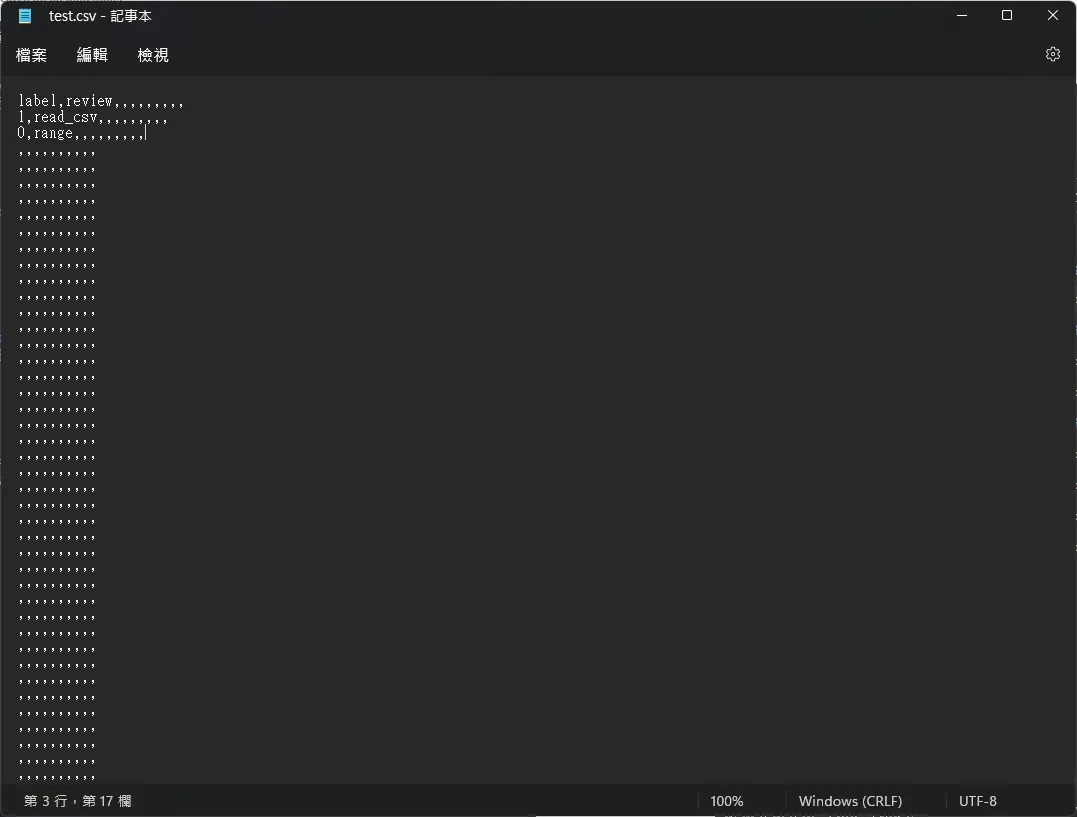 在jwp_train_bce.py 他應該是把一個10k的檔案前面劃分為訓練資料後面的7000換為測試資料,主要是防止過擬和或者還有其他因素..
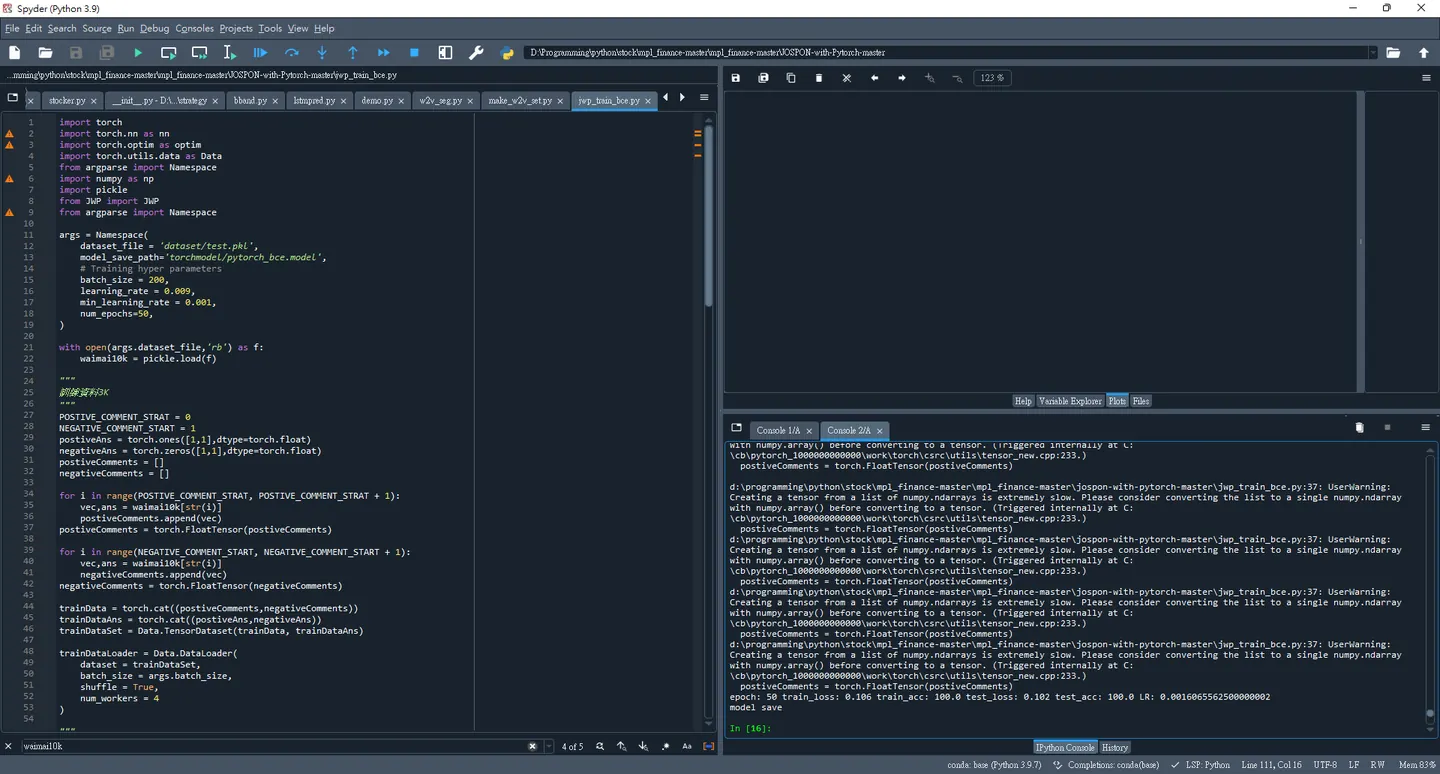
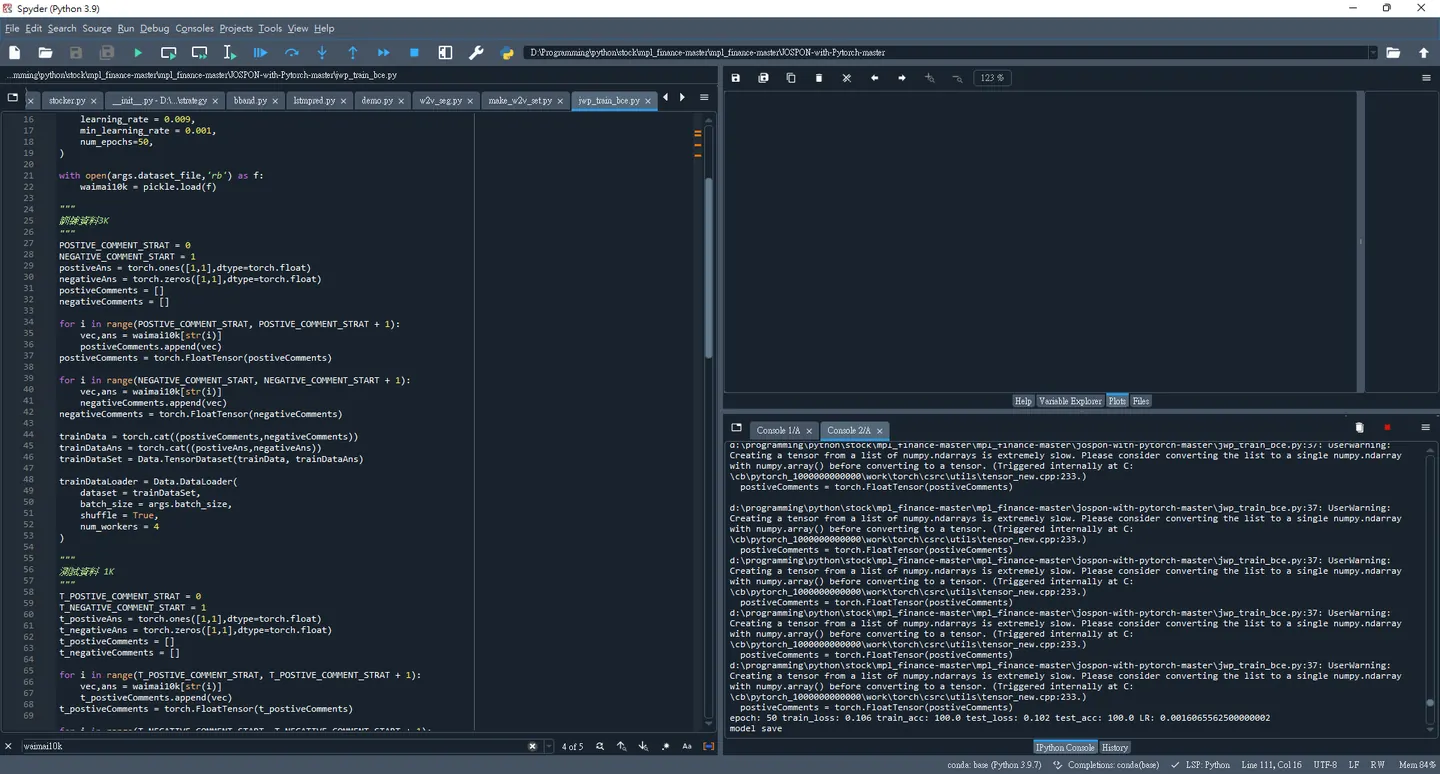 開始訓練50次
可以看到根據訓練好的模型除非很接近關鍵字想要的字的權重
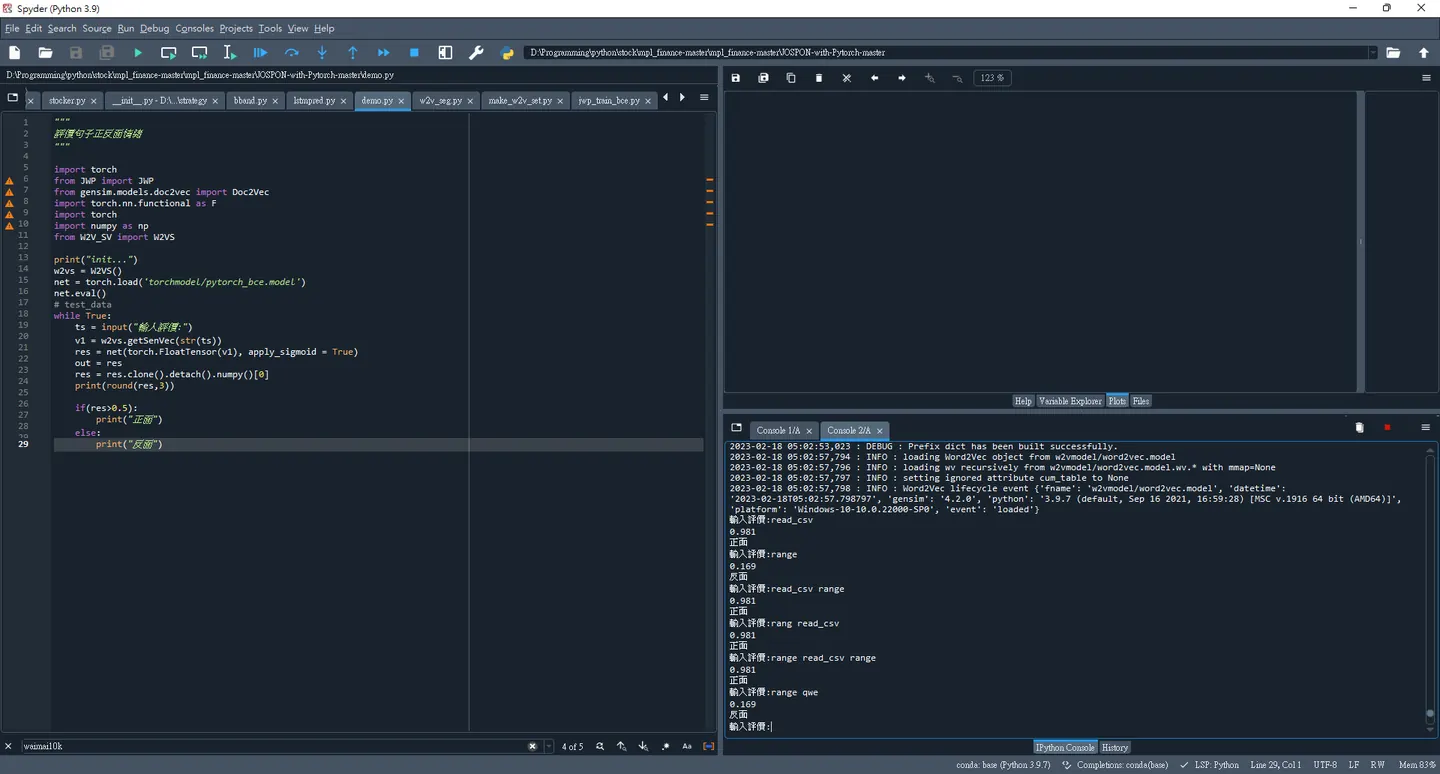 像是
read_csv 可以獲得0.981
但是
read 獲得 0.169
進一步測試其他的
_ 0.994
csv 0.942
所以這個模型假設你輸入含有
_和 csv 很有可能得到正面的輸出
再來重複驗證一下
kocsv 0.169
排除csv
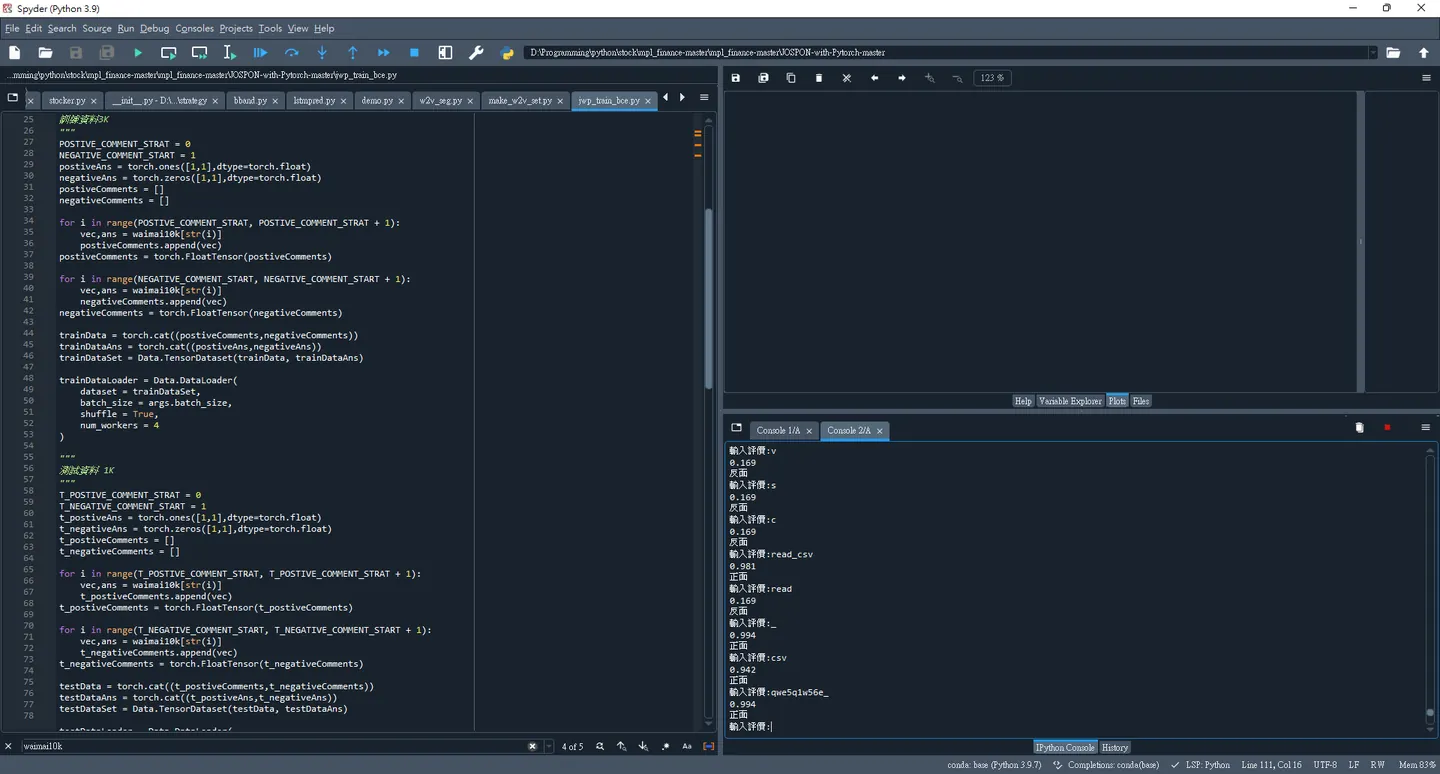 所以核心靈魂有_這個模型就有可能直接輸出為正面
比較有趣的事或許asm 可以判斷register alias 或者是金融新聞的新聞正面負面等等算是另一外一種指標
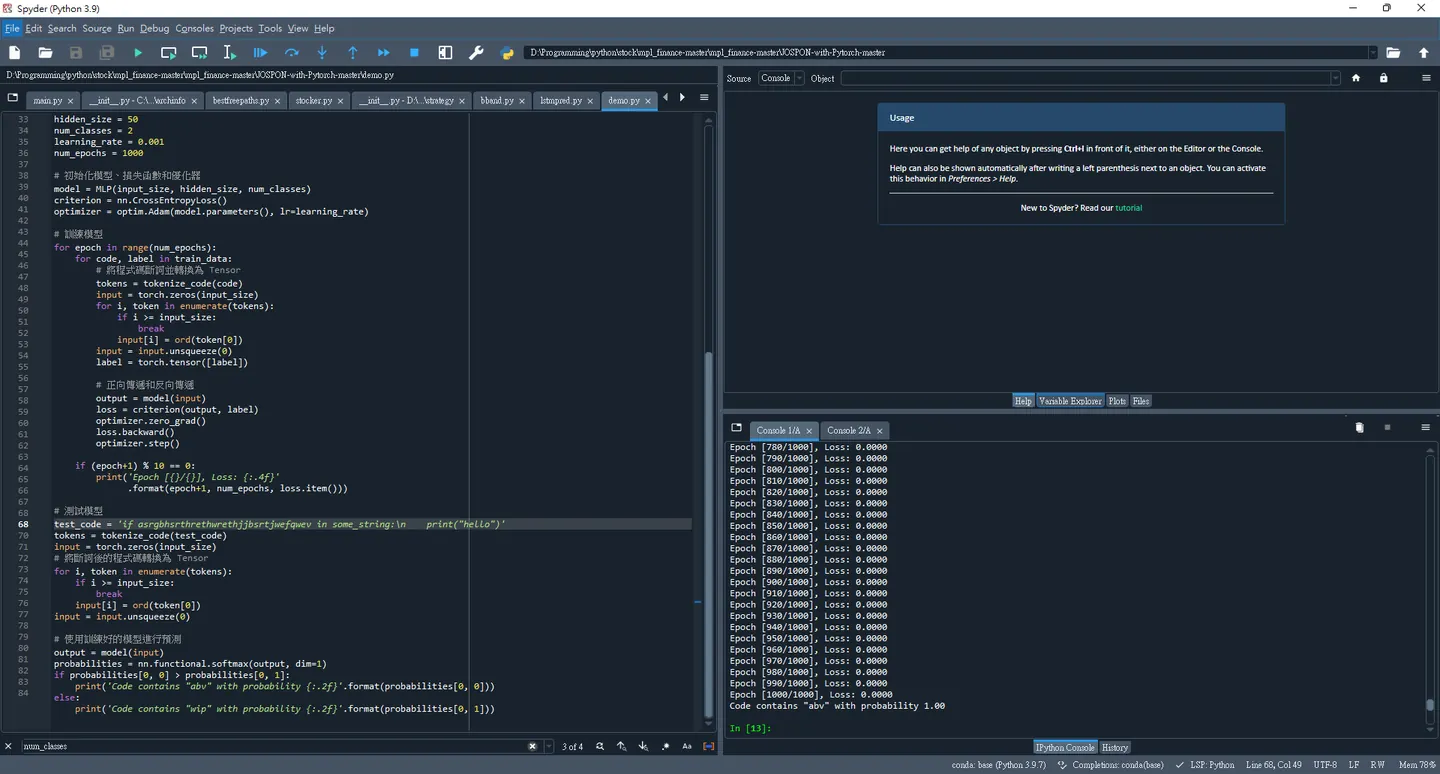
問個chargpt 的版本
import jieba
import torch
import torch.nn as nn
import torch.optim as optim

# 定義 MLP 模型
class MLP(nn.Module):
    def __init__(self, input_size, hidden_size, num_classes):
        super(MLP, self).__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_size, num_classes)

    def forward(self, x):
        out = self.fc1(x)
        out = self.relu(out)
        out = self.fc2(out)
        return out

# 定義斷詞函數
def tokenize_code(code):
    tokens = jieba.lcut(code)
    return [token for token in tokens if token != ' ']

# 加載數據集
train_data = [('print("hello abv")', 1),
              ('def some_function():\n    print("wip")', 2),
              ('if a > b:\n    print("c")', 0),
              ('for i in range(10):\n    print(i)', 0)]

# 定義超參數
input_size = 100
hidden_size = 50
num_classes = 3
learning_rate = 0.001
num_epochs = 1000

# 初始化模型、損失函數和優化器
model = MLP(input_size, hidden_size, num_classes)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)

# 訓練模型
for epoch in range(num_epochs):
    for code, label in train_data:
        # 將程式碼斷詞並轉換為 Tensor
        tokens = tokenize_code(code)
        input = torch.zeros(input_size)
        for i, token in enumerate(tokens):
            if i >= input_size:
                break
            input[i] = ord(token[0])
        input = input.unsqueeze(0)
        label = torch.tensor([label])

        # 正向傳遞和反向傳遞
        output = model(input)
        loss = criterion(output, label)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    if (epoch+1) % 10 == 0:
        print('Epoch [{}/{}], Loss: {:.4f}'
              .format(epoch+1, num_epochs, loss.item()))

# 測試模型
test_code = 'if asrghsrthrethwipwrethjj>wipbsrtjwwiefqpwe in some_string:\n    print("hello")'
tokens = tokenize_code(test_code)
input = torch.zeros(input_size)
# 將斷詞後的程式碼轉換為 Tensor
for i, token in enumerate(tokens):
    if i >= input_size:
        break
    input[i] = ord(token[0])
input = input.unsqueeze(0)

# 使用訓練好的模型進行預測
output = model(input)
probabilities = nn.functional.softmax(output, dim=1)
print(probabilities)
# if probabilities[0, 0] > probabilities[0, 1]:
print('Code contains "abv" with probability {:.2f}'.format(probabilities[0, 0]))
# else:
print('Code contains "wip" with probability {:.2f}'.format(probabilities[0, 1]))
# 加載數據集
train_data = [('print("hello abv")', 1),
              ('def some_function():\n    print("wip")', 2),
              ('if a > b:\n    print("c")', 0),
              ('for i in range(10):\n    print(i)', 0)]
最後輸出的機率是tensor([[0.7671, 0.0020, 0.2308]], grad_fn=
    # 加載數據集
train_data = [('print("hello abv")',0),
              ('def some_function():', 1),
              ('def some_function():\print("wip")', 1),
              ('print("wip")', 1),
              ('if a > b:\n    print("c")', 2),
              ('for i in range(10):\n    print(i)', 2)]

# 測試模型
test_code = 'def some_function():\n)'
tokens = tokenize_code(test_code)
input = torch.zeros(input_size)
# 將斷詞後的程式碼轉換為 Tensor
for i, token in enumerate(tokens):
    if i >= input_size:
        break
    input[i] = ord(token[0])
input = input.unsqueeze(0)

# 使用訓練好的模型進行預測
output = model(input)
probabilities = nn.functional.softmax(output, dim=1)
print(output)
print(probabilities)
predicted_class = torch.argmax(probabilities, dim=1).item()
print(predicted_class )
predicted_class = torch.argmax(probabilities, dim=1).item()
修改後的程式碼順便印出像對應的類別,這邊我對數據集添加了兩個類別為1的 ,大概就是在想說斷詞斷的多細,某些文字的特徵就有可能越會被偵測到,讓輸出往數據集的分類靠
Comments