
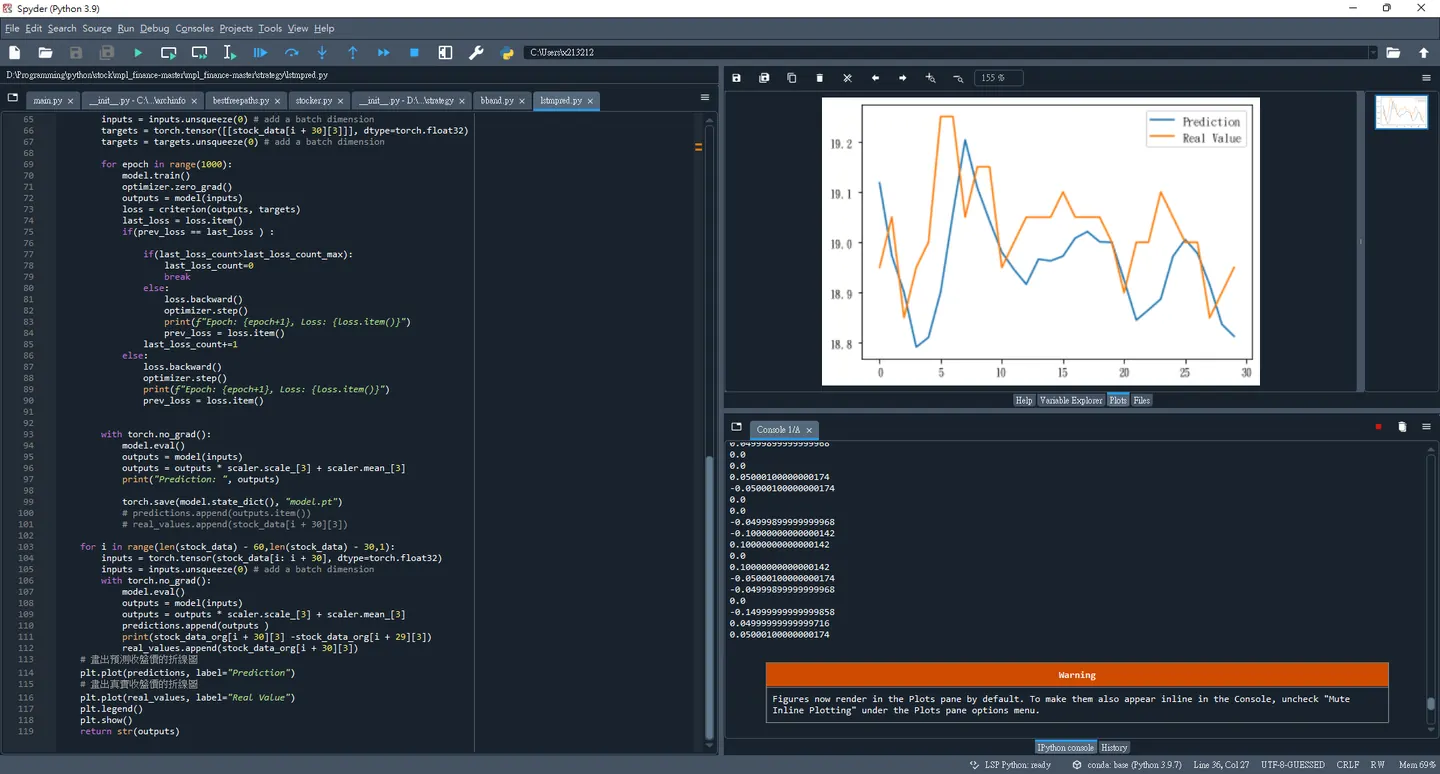
lstm
import torch
import torch.nn as nn
import numpy as np
import torch.optim as optim
import strategy.popular_model as popmoder
import os
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
def generate_random_stock_data(days=30, features=5):
    return np.random.rand(days, features) * 100

class LSTM(nn.Module):
    def __init__(self, input_size, hidden_size, num_layers, num_classes):
        super(LSTM, self).__init__()
        self.hidden_size = hidden_size
        self.num_layers = num_layers
        self.lstm = nn.LSTM(input_size, hidden_size, num_layers, batch_first=True)
        self.fc = nn.Linear(hidden_size, num_classes)

    def forward(self, x):
        h0 = torch.zeros(self.num_layers, x.size(0), self.hidden_size)
        c0 = torch.zeros(self.num_layers, x.size(0), self.hidden_size)
        out, _ = self.lstm(x, (h0, c0))
        out = self.fc(out[:, -1, :])
        return out

def lstm(parmam):
    input_size = 5
    hidden_size = 64
    num_layers = 1
    num_classes = 1
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print(device)

    model = LSTM(input_size, hidden_size, num_layers, num_classes)
    stock_data = parmam[5]
    stock_data_org = parmam[5]

    stock_data = np.array(parmam[5])
    stock_data = np.array(stock_data)
    scaler = StandardScaler()
    scaler.fit(stock_data)
    stock_data = scaler.transform(stock_data)
    # print(stock_data)
    criterion = nn.MSELoss(reduction='mean')
    # optimizer = optim.SGD(model.parameters(), lr=0.01)
    LR = 0.0001
    optimizer = torch.optim.Adam(model.parameters(), lr=LR)
    # 預測收盤價的列表
    predictions = []
    # 真實收盤價的列表
    real_values = []

    # 檢查檔案是否存在
    if os.path.isfile("model.pt"):
      model.load_state_dict(torch.load("model.pt"))
    prev_loss = 0
    last_loss = 0
    last_loss_count = 0
    last_loss_count_max = 10
    for i in range(0, len(stock_data) - 30, 30):


        inputs = torch.tensor(stock_data[i: i + 30], dtype=torch.float32)
        inputs = inputs.unsqueeze(0) # add a batch dimension
        targets = torch.tensor([[stock_data[i + 30][3]]], dtype=torch.float32)
        targets = targets.unsqueeze(0) # add a batch dimension

        for epoch in range(1000):
            model.train()
            optimizer.zero_grad()
            outputs = model(inputs)
            loss = criterion(outputs, targets)
            last_loss = loss.item()
            if(prev_loss == last_loss ) :

                if(last_loss_count>last_loss_count_max):
                    last_loss_count=0
                    break
                else:
                    loss.backward()
                    optimizer.step()
                    print(f"Epoch: {epoch+1}, Loss: {loss.item()}")
                    prev_loss = loss.item()
                last_loss_count+=1
            else:
                loss.backward()
                optimizer.step()
                print(f"Epoch: {epoch+1}, Loss: {loss.item()}")
                prev_loss = loss.item()


        with torch.no_grad():
            model.eval()
            outputs = model(inputs)
            outputs = outputs * scaler.scale_[3] + scaler.mean_[3]
            print("Prediction: ", outputs)

            torch.save(model.state_dict(), "model.pt")
            # predictions.append(outputs.item())
            # real_values.append(stock_data[i + 30][3])

    for i in range(len(stock_data) - 60,len(stock_data) - 30,1):
        inputs = torch.tensor(stock_data[i: i + 30], dtype=torch.float32)
        inputs = inputs.unsqueeze(0) # add a batch dimension
        with torch.no_grad():
            model.eval()
            outputs = model(inputs)
            outputs = outputs * scaler.scale_[3] + scaler.mean_[3]
            predictions.append(outputs )
            print(stock_data_org[i + 30][3] -stock_data_org[i + 29][3])
            real_values.append(stock_data_org[i + 30][3])
    # 畫出預測收盤價的折線圖
    plt.plot(predictions, label="Prediction")
    # 畫出真實收盤價的折線圖
    plt.plot(real_values, label="Real Value")
    plt.legend()
    plt.show()
    return str(outputs)
預測最後30天,
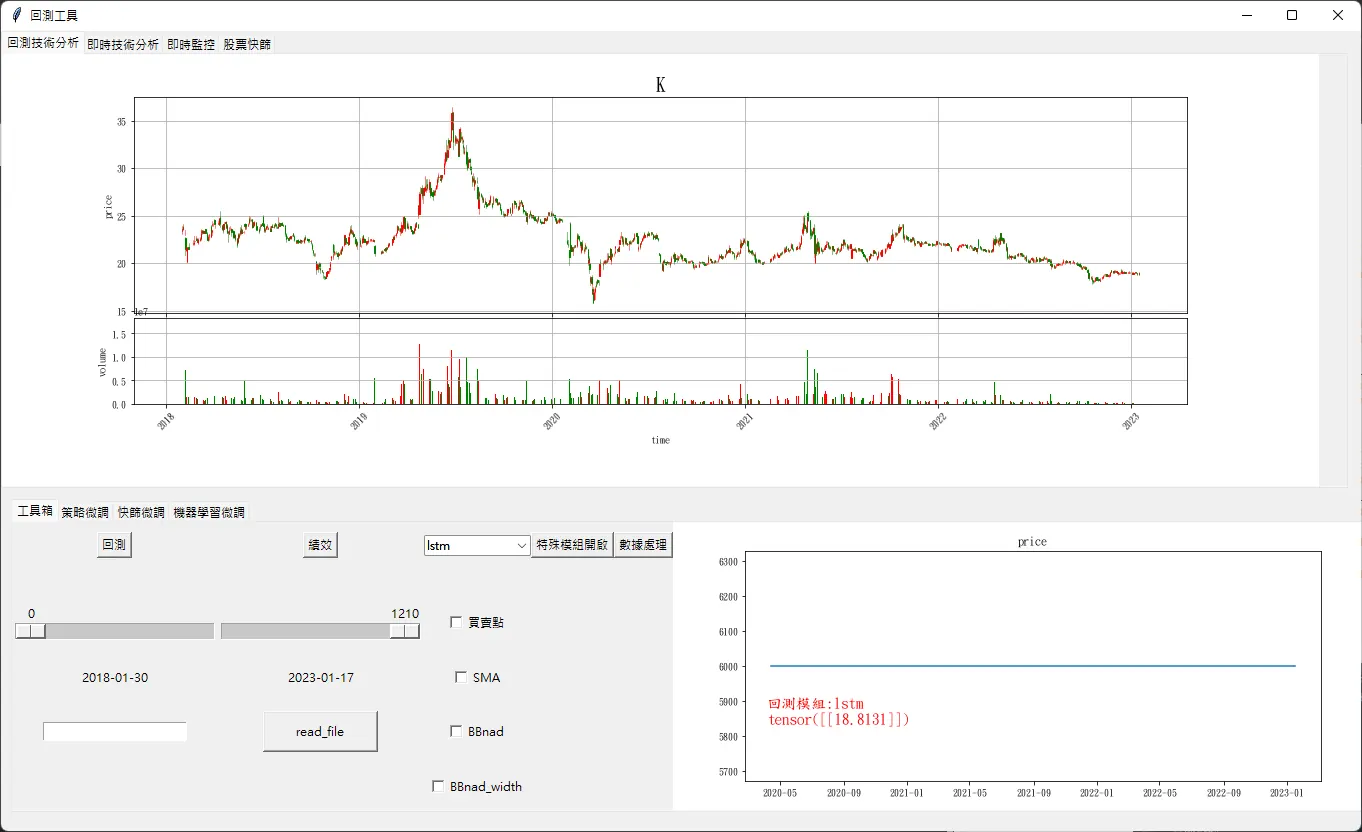 大概全部重構完基本要研究進行擴增蠻方便的,近期來學pytorch,並嘗試把以前想看的一些資料做整理
Comments