
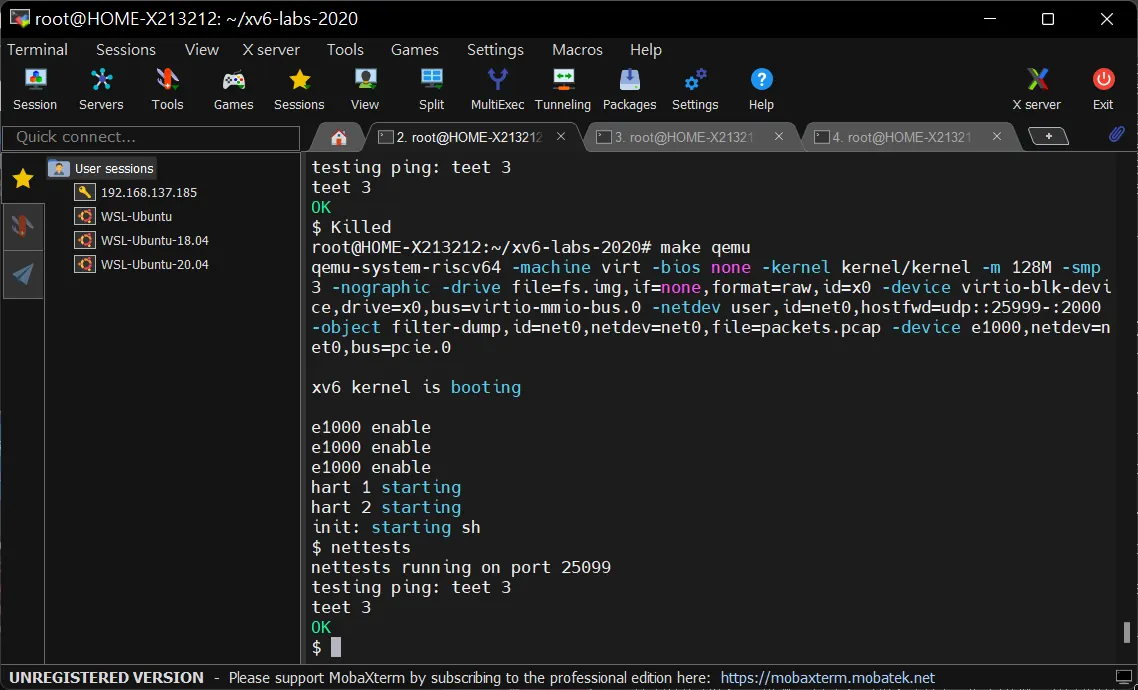
xv6 network-net
快速記錄一下在xv6 system 上如果要實現一個網卡驅動大致上會經過哪一些環節,算是興趣的很想知道一個OS如何實現網卡連接外部設備我們直接跳最後一個lab來了解一下,這邊只是粗略分析,結合以前看的一些東西做一些聯想與總結,在某些部分可能有理解錯誤請見諒。
main.c
從 asm 一路跳轉過來 main,讓作業系統可以透過 c 語言去撰寫,中間會經過很多設置,這邊我們專注在code 整體流程來trace 一下
#ifdef LAB_NET
    pci_init();
    sockinit();
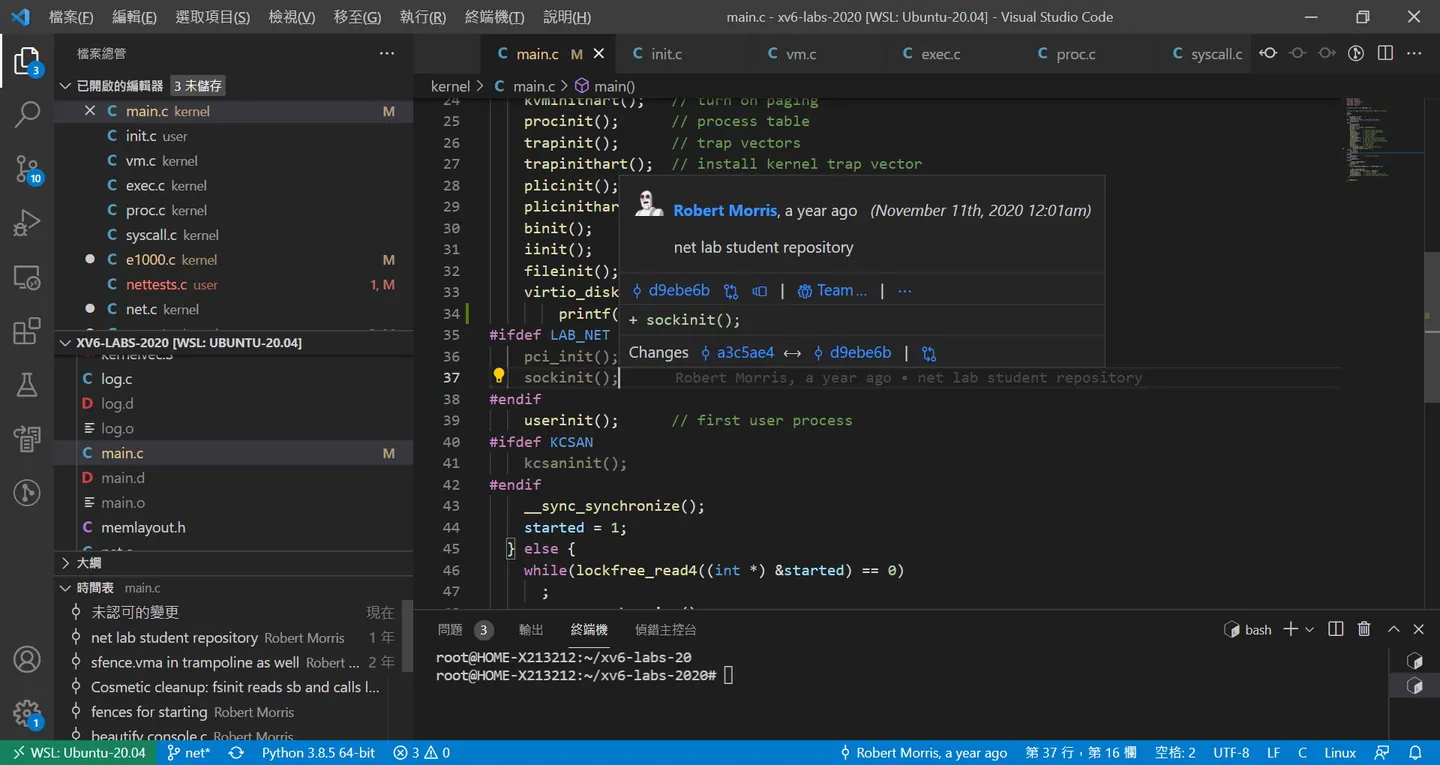
pci_init
可以看到 pci 透過 qemu 可能會在記憶體初始化的時候載入於一個記憶體區段,於vm.c 可以進一步得知register 會放在這裡,下面就是在尋找有關於網卡的id
// 100e:8086 is an e1000 if(id == 0x100e8086){
void
pci_init()
{
    printf("e1000 enable \n" );
  // we'll place the e1000 registers at this address.
  // vm.c maps this range.
  uint64 e1000_regs = 0x40000000L;

  // qemu -machine virt puts PCIe config space here.
  // vm.c maps this range.
  uint32  *ecam = (uint32 *) 0x30000000L;

  // look at each possible PCI device on bus 0.
  for(int dev = 0; dev < 32; dev++){
    int bus = 0;
    int func = 0;
    int offset = 0;
    uint32 off = (bus << 16) | (dev << 11) | (func << 8) | (offset);
    volatile uint32 *base = ecam + off;
    uint32 id = base[0];

    // 100e:8086 is an e1000
    if(id == 0x100e8086){
vm.c
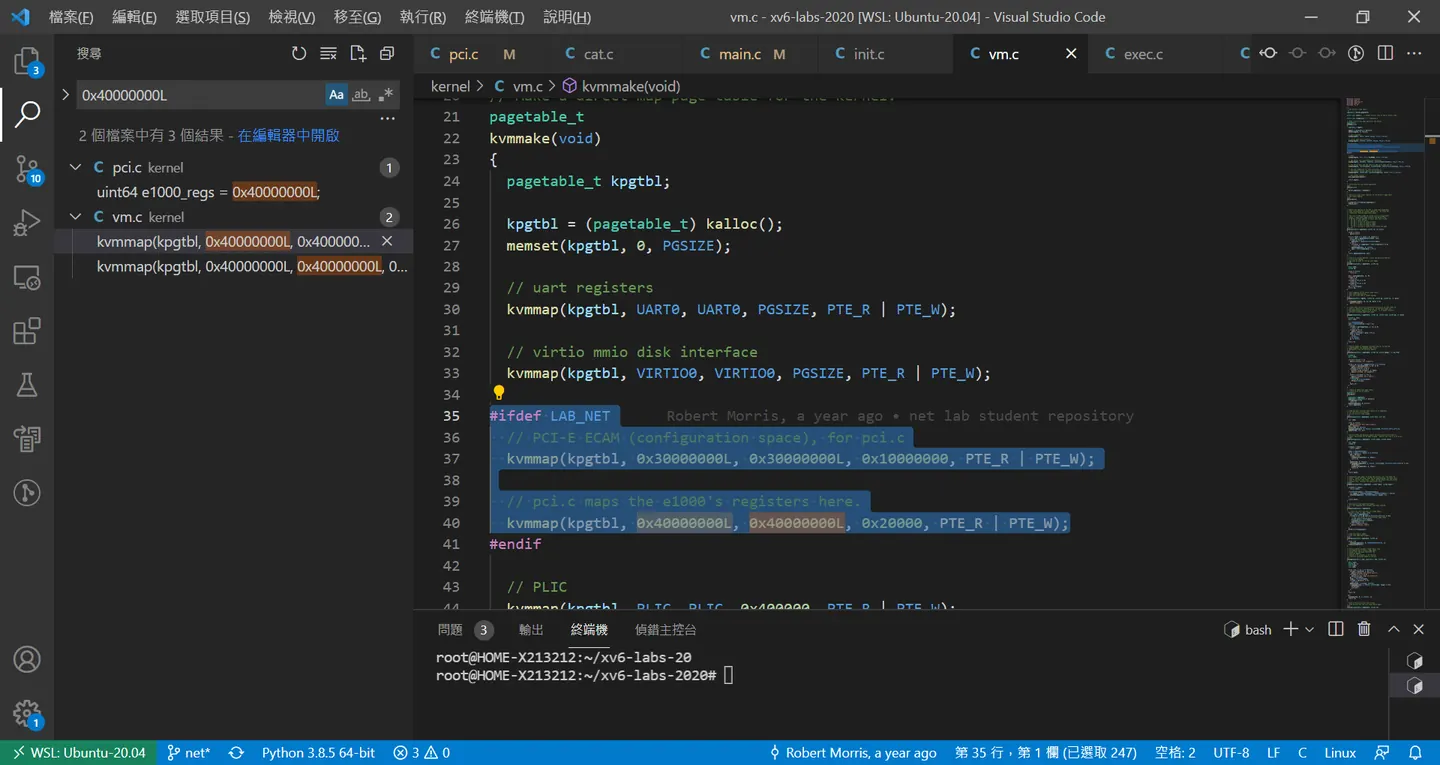
#ifdef LAB_NET
  // PCI-E ECAM (configuration space), for pci.c
  kvmmap(kpgtbl, 0x30000000L, 0x30000000L, 0x10000000, PTE_R | PTE_W);

  // pci.c maps the e1000's registers here.
  kvmmap(kpgtbl, 0x40000000L, 0x40000000L, 0x20000, PTE_R | PTE_W);
初步推理可以得到在中斷pic 找到網卡後會進行 初始化的動作
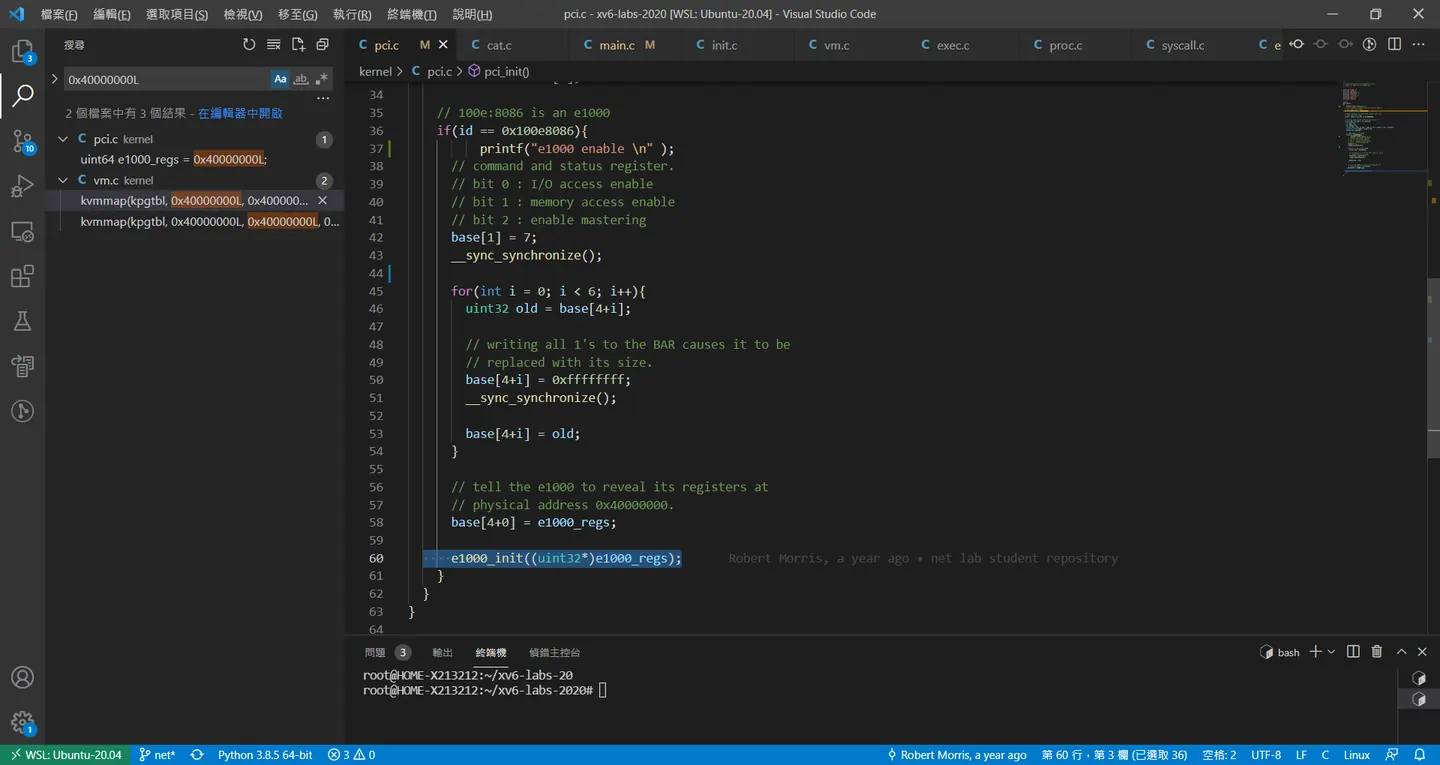
e1000_init((uint32*)e1000_regs);
e1000.c
到這邊可以看到實際上的網卡,可以想成現在網卡的register 都會寫到我們剛剛的記憶體位置
uint64 e1000_regs = 0x40000000L;
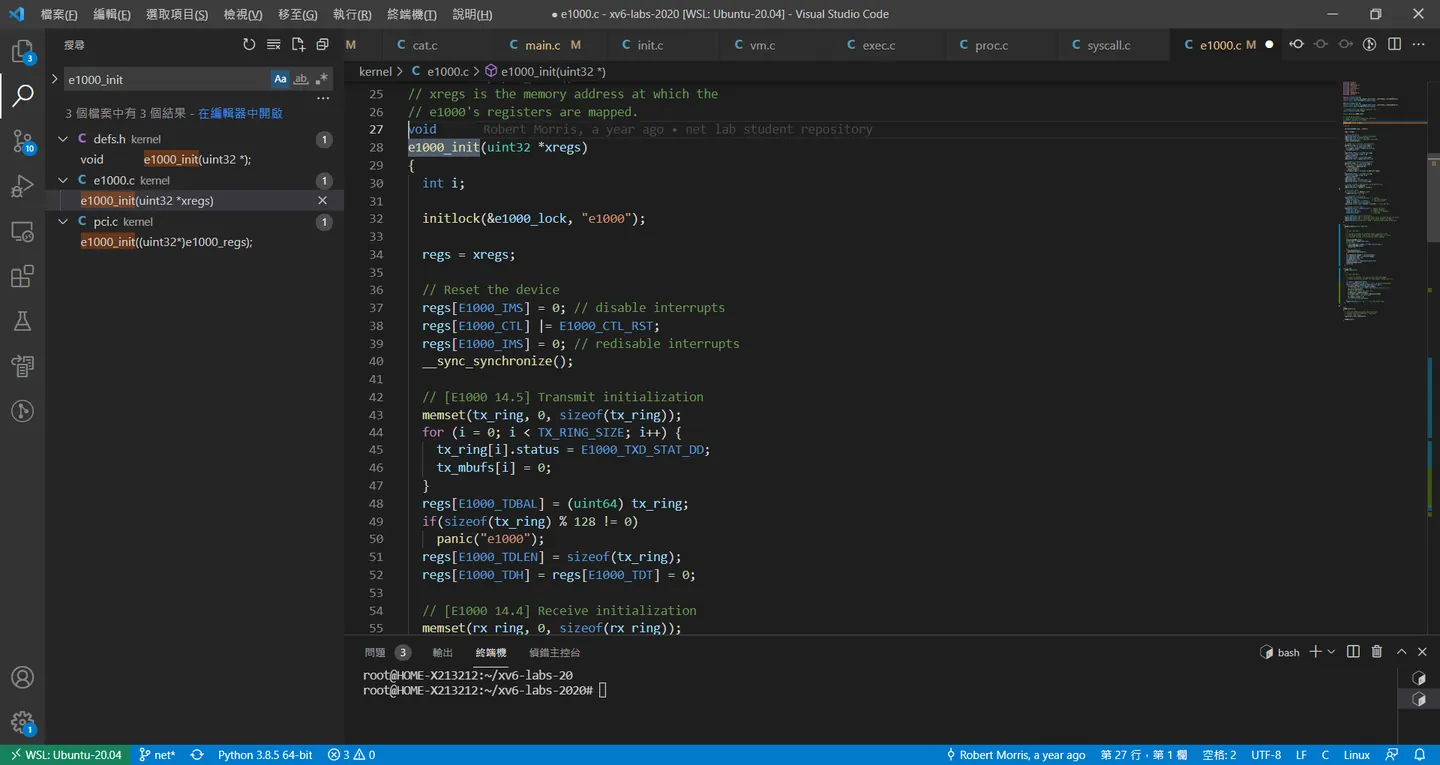 可以關注於
tx_ring
rx_ring
在一般中斷可能會透過 pic 主動對 system 發生interrupt,但是面對 滑鼠 網卡這些總不可能持續的對作業系統發生中斷,這會讓cpu 無法為其他process 進行系統調度,所以可能視情況
polling,或者讓 device 自行發出中斷,
另一方面的設計概念在30 day os 也有 也就是環狀的 buffer主要就是當你的設備遇到組合鍵,或者,連續得input 你的array 總不可能大小是無限大,那麼解決這種問題環狀的buffer 就是比較好的解法,當然用在教學用的xv6 作業系統也是比較好實作。
 // [E1000 14.5] Transmit initialization
  memset(tx_ring, 0, sizeof(tx_ring));
  for (i = 0; i < TX_RING_SIZE; i++) {
    tx_ring[i].status = E1000_TXD_STAT_DD;
    tx_mbufs[i] = 0;
  }
  regs[E1000_TDBAL] = (uint64) tx_ring;
  if(sizeof(tx_ring) % 128 != 0)
    panic("e1000");
  regs[E1000_TDLEN] = sizeof(tx_ring);
  regs[E1000_TDH] = regs[E1000_TDT] = 0;

  // [E1000 14.4] Receive initialization
  memset(rx_ring, 0, sizeof(rx_ring));
  for (i = 0; i < RX_RING_SIZE; i++) {
    rx_mbufs[i] = mbufalloc(0);
    if (!rx_mbufs[i])
      panic("e1000");
    rx_ring[i].addr = (uint64) rx_mbufs[i]->head;
  }
  regs[E1000_RDBAL] = (uint64) rx_ring;
  if(sizeof(rx_ring) % 128 != 0)
    panic("e1000");
  regs[E1000_RDH] = 0;
  regs[E1000_RDT] = RX_RING_SIZE - 1;
  regs[E1000_RDLEN] = sizeof(rx_ring);
mac setting
// filter by qemu's MAC address, 52:54:00:12:34:56 當網卡在一般區域網路可能可以用 MAC 當作唯一值,但是到互聯網就會需要結合 IP 來產生一組唯一值,透過ROUTER 層解析 IP HEADER 進一步把資料送到你家
  // filter by qemu's MAC address, 52:54:00:12:34:56
  regs[E1000_RA] = 0x12005452;
  regs[E1000_RA+1] = 0x5634 | (1<<31);
後面就是一些 REGISTER 的操作,讓網卡可以根據BIT 來決定動作
  // transmitter control bits.
  regs[E1000_TCTL] = E1000_TCTL_EN |  // enable
    E1000_TCTL_PSP |                  // pad short packets
    (0x10 << E1000_TCTL_CT_SHIFT) |   // collision stuff
    (0x40 << E1000_TCTL_COLD_SHIFT);
  regs[E1000_TIPG] = 10 | (8<<10) | (6<<20); // inter-pkt gap

  // receiver control bits.
  regs[E1000_RCTL] = E1000_RCTL_EN | // enable receiver
    E1000_RCTL_BAM |                 // enable broadcast
    E1000_RCTL_SZ_2048 |             // 2048-byte rx buffers
    E1000_RCTL_SECRC;                // strip CRC

  // ask e1000 for receive interrupts.
  regs[E1000_RDTR] = 0; // interrupt after every received packet (no timer)
  regs[E1000_RADV] = 0; // interrupt after every packet (no timer)
  regs[E1000_IMS] = (1 << 7); // RXDW -- Receiver Descriptor Write Back
TX & RX
在實驗步驟可能要完成這兩個FUCNTION 才能進一步的通過 unittest,在這兩個裡面到底會經過哪一些步驟我們慢慢看,可以觀察裡面的tx_ring 和 buffer 到底是什麼,我們回到 xv6 的 file_system 實現
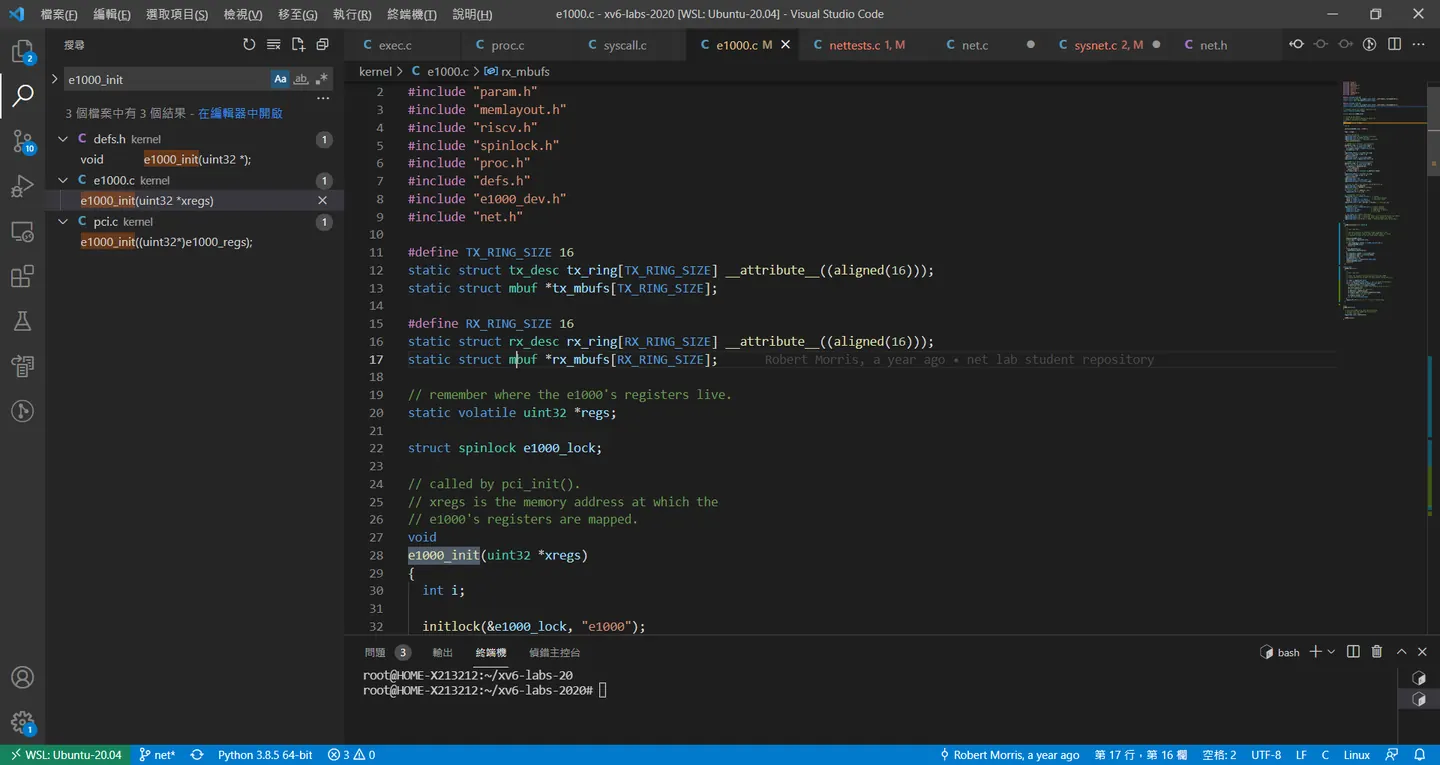
#define TX_RING_SIZE 16
static struct tx_desc tx_ring[TX_RING_SIZE] __attribute__((aligned(16)));
static struct mbuf *tx_mbufs[TX_RING_SIZE];

#define RX_RING_SIZE 16
static struct rx_desc rx_ring[RX_RING_SIZE] __attribute__((aligned(16)));
static struct mbuf *rx_mbufs[RX_RING_SIZE];
if (tx_ring[tail].status != E1000_TXD_STAT_DD) {
if(tx_mbufs[tail])
while (rx_ring[i].status & E1000_RXD_STAT_DD) {
net_rx(rx_mbufs[i]);
int e1000_transmit(struct mbuf* m)
int
    e1000_transmit(struct mbuf* m)
    {
      //
      // Your code here.
      //
      // the mbuf contains an ethernet frame; program it into
      // the TX descriptor ring so that the e1000 sends it. Stash
      // a pointer so that it can be freed after sending.
      //
      acquire(&e1000_lock);
      uint32 tail = regs[E1000_TDT];
      // overflow
      if (tx_ring[tail].status != E1000_TXD_STAT_DD) {
        release(&e1000_lock);
        return -1;
      }
      if(tx_mbufs[tail]){
        mbuffree(tx_mbufs[tail]);
      }
      tx_ring[tail].length = (uint16)m->len;
      tx_ring[tail].addr = (uint64)m->head;
      tx_ring[tail].cmd = 9;
      tx_mbufs[tail] = m;
      regs[E1000_TDT] = (tail+1)%TX_RING_SIZE;
      release(&e1000_lock);
      return 0;
    }
static void e1000_recv(void)
static void
    e1000_recv(void)
    {
      //
      // Your code here.
      //
      // Check for packets that have arrived from the e1000
      // Create and deliver an mbuf for each packet (using net_rx()).
      //
      int tail = regs[E1000_RDT];
      int i = (tail+1)%RX_RING_SIZE; // tail is owned by Hardware!
      while (rx_ring[i].status & E1000_RXD_STAT_DD) {
        rx_mbufs[i]->len = rx_ring[i].length;
        // send mbuf to upper level (the network stack in net.c).
        net_rx(rx_mbufs[i]);
        // get a new buffer for next recv.
        rx_mbufs[i] = mbufalloc(0);
        rx_ring[i].addr = (uint64)rx_mbufs[i]->head;
        // update status for next recv.
        rx_ring[i].status = 0;
        i = (i + 1) % RX_RING_SIZE;
      }
      regs[E1000_RDT] = i - 1; // - 1 for the while loop.
    }
xv6 filesystem / network
我們知道linux 的設計概念為,一切皆是文件
在剛才的部分不管是
mbuf 還是 TX_RING,RX_RING 看起來就像是把資料放在 BUFFER,那麼 buffer 的元素放置的其實放的就是 檔案
端看結構體可以稍微猜一下剛才我們的
環狀buffer 長這樣
https://zhuanlan.zhihu.com/p/351563871
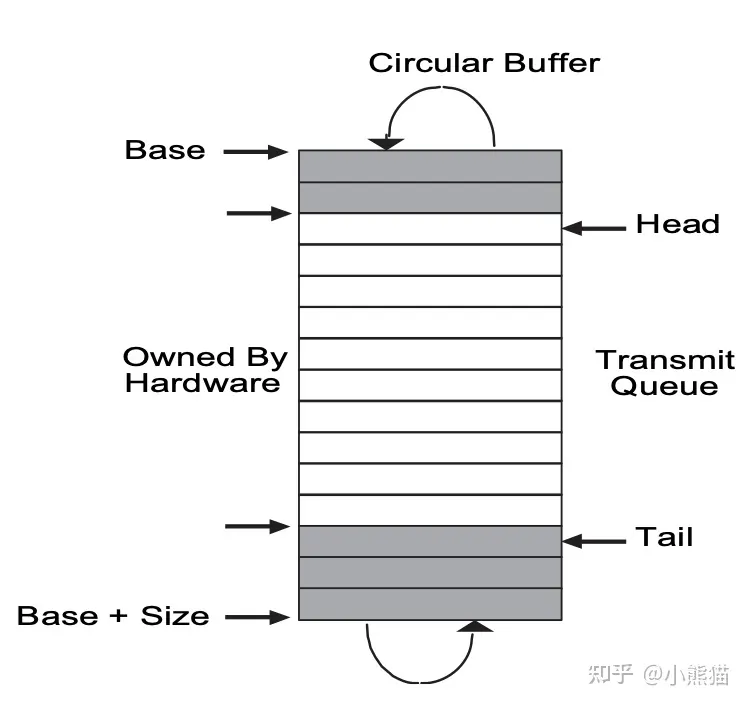 透過讀寫 register 的狀態,因為在udp/tcp 可能在某一些情況光靠軟體的 lock 可能不太可靠,更多可能要依賴 硬體的 register 狀態 或者 flag 來進行精準判斷 資料是否已經傳輸完畢,或者描述各種狀態
那麼當資料進來的時候又會發生什麼事情。
lwip
這邊只是稍微的看過可以把他想成,在面對無 os 或者 有 os 又有網卡的 嵌入式系統怎麼進行 網卡上的傳輸,所以就有人利用軟體在硬體上實現一個抽象層,讓嵌入式可以進行資料上的傳輸
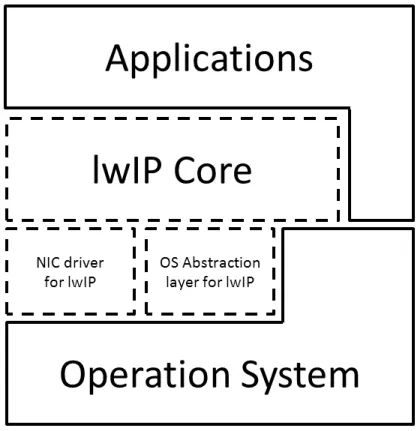 透過封裝過後的 system_call 可以更好的銜接到我們的 os 以便可以實現網路卡驅動的部分。
我這邊把網路的data 想成不斷的在資料的片段上去加上 ip header,這邊又會涉及到 socket 的原理機制我們從測資上 回推 整個設計概念
/// ping(2000, dport, 1);
nettest / ping
ping(2000, dport, 1);
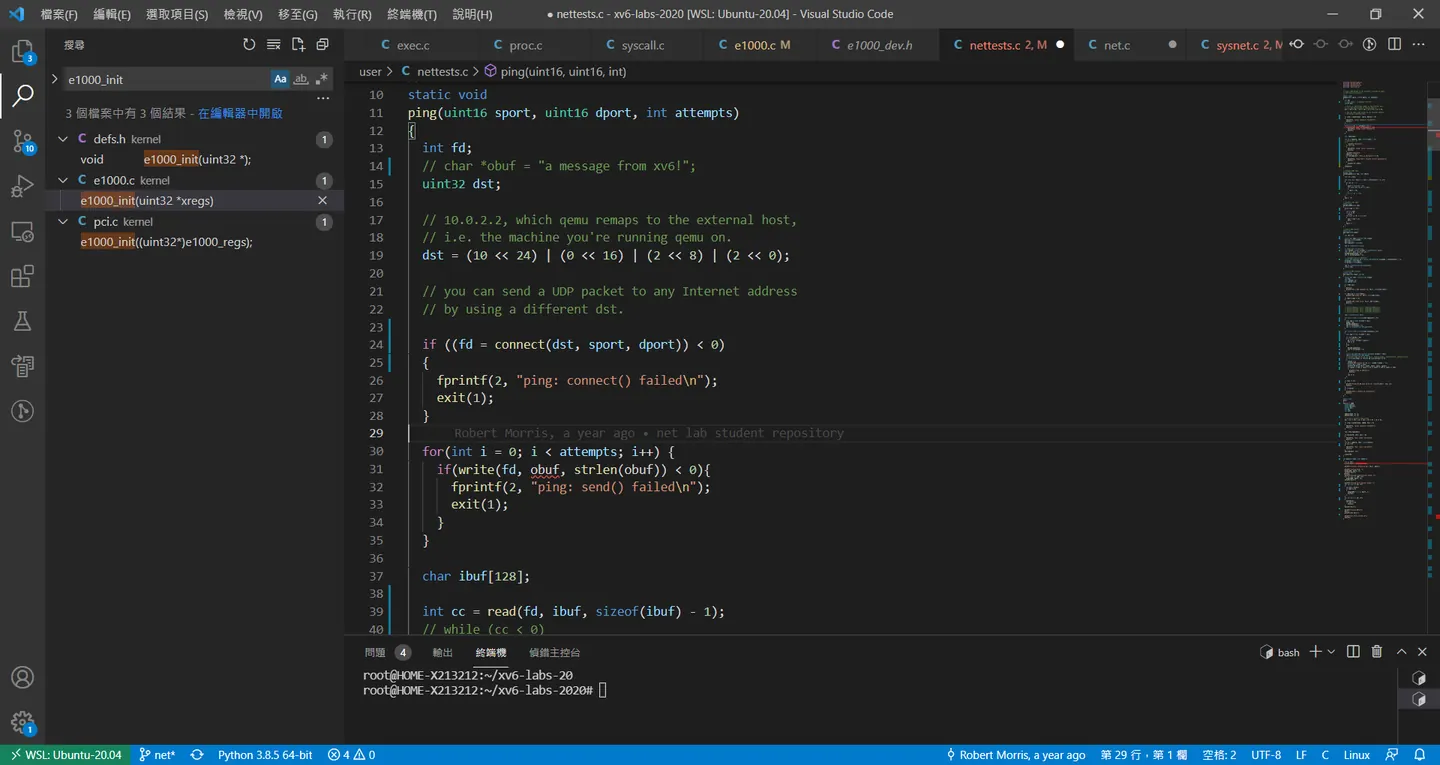 撇除一切比較關於傳輸協議的東西,我們回歸上一個小章節,linux 設計概念一切皆為檔案的方式,可以看到 下列udp 傳輸範例裡面又是對 file 去做操作,當然在實驗裡面沒有實現server 的功能,只有簡單的 udp 去建立的傳輸,下列是使用udp 協議通訊的程式碼
  if ((fd = connect(dst, sport, dport)) < 0)
  {
    fprintf(2, "ping: connect() failed\n");
    exit(1);
  }

  for(int i = 0; i < attempts; i++) {
    if(write(fd, obuf, strlen(obuf)) < 0){
      fprintf(2, "ping: send() failed\n");
      exit(1);
    }
  }

  char ibuf[128];

  int cc = read(fd, ibuf, sizeof(ibuf) - 1);
我們往system call 去查看
user.c
在更前面的例子有敘述怎麼構造 system call 的範例
connect
#ifdef LAB_NET
int
sys_connect(void)
{
  struct file *f;
  int fd;
  uint32 raddr;
  uint32 rport;
  uint32 lport;

  if (argint(0, (int*)&raddr) < 0 ||
      argint(1, (int*)&lport) < 0 ||
      argint(2, (int*)&rport) < 0) {
    return -1;
  }

  if(sockalloc(&f, raddr, lport, rport) < 0)
    return -1;
  if((fd=fdalloc(f)) < 0){
    fileclose(f);
    return -1;
  }

  return fd;
}
#endif
專注於 if(sockalloc(&f, raddr, lport, rport) < 0) 可以看到當我們去 connect 其實就是去產生一個檔案,其中也可以看到檔案的type 設為 (*f)->type = FD_SOCK;
int
sockalloc(struct file **f, uint32 raddr, uint16 lport, uint16 rport)
{
  struct sock *si, *pos;

  si = 0;
  *f = 0;
  if ((*f = filealloc()) == 0)
    goto bad;
  if ((si = (struct sock*)kalloc()) == 0)
    goto bad;

  // initialize objects
  si->raddr = raddr;
  si->lport = lport;
  si->rport = rport;
  initlock(&si->lock, "sock");
  mbufq_init(&si->rxq);
  (*f)->type = FD_SOCK;
  (*f)->readable = 1;
  (*f)->writable = 1;
  (*f)->sock = si;

  // add to list of sockets
  acquire(&lock);
  pos = sockets;
  while (pos) {
    if (pos->raddr == raddr &&
        pos->lport == lport &&
    pos->rport == rport) {
      release(&lock);
      goto bad;
    }
    pos = pos->next;
  }
  si->next = sockets;
  sockets = si;
  release(&lock);
  return 0;

bad:
  if (si)
    kfree((char*)si);
  if (*f)
    fileclose(*f);
  return -1;
}
我們可以建立很多 socket,這邊我的理解是在網路你可能會有很多個連線連進來,一個 socket 是絕對不夠用的所以有個 list 來進行管理
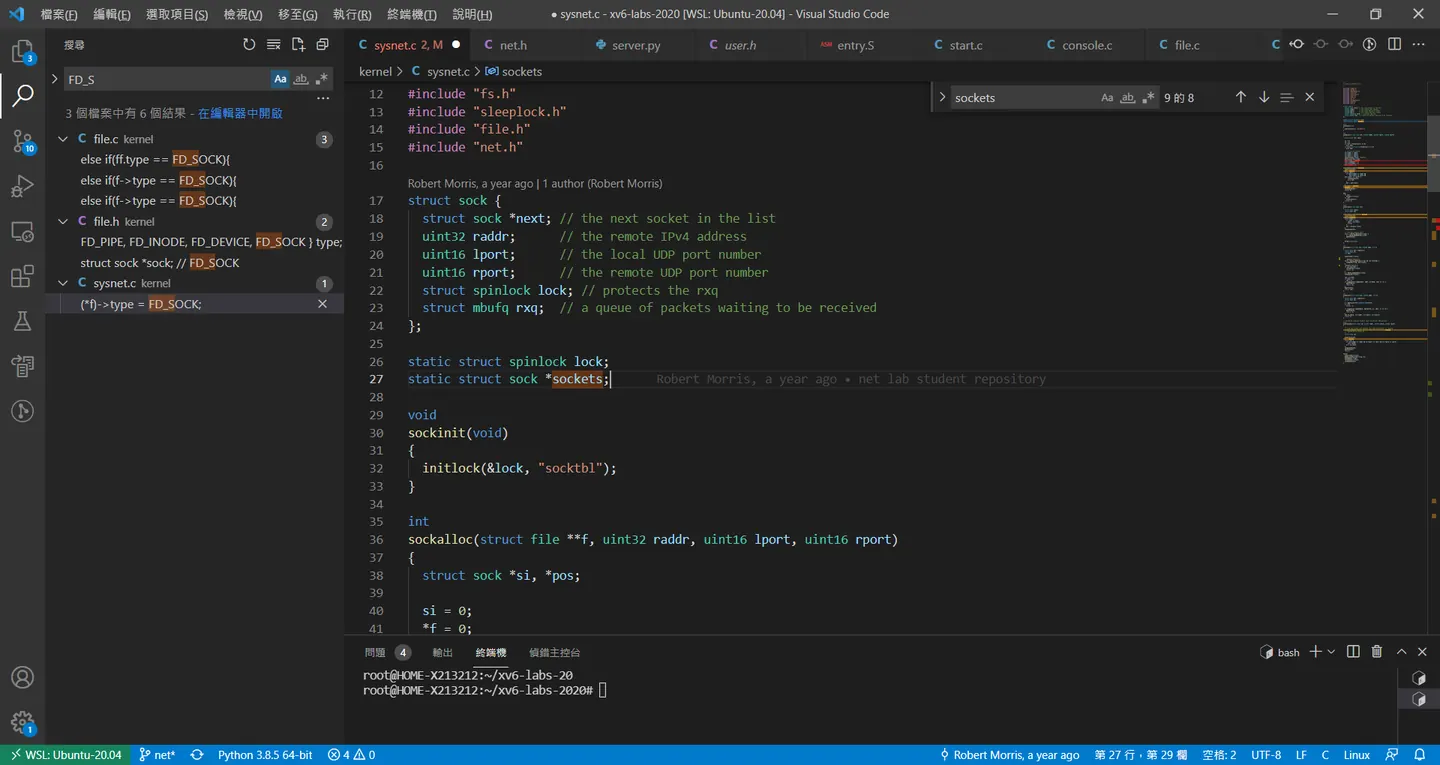
struct sock {
  struct sock *next; // the next socket in the list
  uint32 raddr;      // the remote IPv4 address
  uint16 lport;      // the local UDP port number
  uint16 rport;      // the remote UDP port number
  struct spinlock lock; // protects the rxq
  struct mbufq rxq;  // a queue of packets waiting to be received
};
如果已經找到已有的ip 和 port 則不能連線
    if (pos->raddr == raddr &&
        pos->lport == lport &&
    pos->rport == rport) {
      release(&lock);
      goto bad;
bad:
  if (si)
    kfree((char*)si);
  if (*f)
    fileclose(*f);
  return -1;
file write/read
仔細看system call 可以看到他的設計概念連到 fileread ,filewrite 其實後面底層決定讀寫要怎麼處理在前面我們有提過 FD_SOCK我們統一對 fd 去做讀寫將會判斷這個flag 來進行socket 的呼叫
uint64
sys_read(void)
{
  struct file *f;
  int n;
  uint64 p;

  if(argfd(0, 0, &f) < 0 || argint(2, &n) < 0 || argaddr(1, &p) < 0)
    return -1;
  return fileread(f, p, n);
}

uint64
sys_write(void)
{
  struct file *f;
  int n;
  uint64 p;

  if(argfd(0, 0, &f) < 0 || argint(2, &n) < 0 || argaddr(1, &p) < 0)
    return -1;

  return filewrite(f, p, n);
}
filewrite
#ifdef LAB_NET
  else if(f->type == FD_SOCK){
    r = sockread(f->sock, addr, n);
  }
fileread
#ifdef LAB_NET
  else if(f->type == FD_SOCK){
    ret = sockwrite(f->sock, addr, n);
  }
不管是sockread,sockwrite 最後都會走到我們網卡最先的完成的兩個fucntion e1000_transmit,e1000_recv
sockread
int
sockread(struct sock *si, uint64 addr, int n)
{
  struct proc *pr = myproc();
  struct mbuf *m;
  int len;

  acquire(&si->lock);

     printf("teet3\n");
  while (mbufq_empty(&si->rxq) && !pr->killed) {
    sleep(&si->rxq, &si->lock);
  }
   printf("teet\n");
  if (pr->killed) {
    release(&si->lock);
    return -1;
  }
  m = mbufq_pophead(&si->rxq);
  release(&si->lock);

  len = m->len;
  if (len > n)
    len = n;
  if (copyout(pr->pagetable, addr, m->head, len) == -1) {
    mbuffree(m);
    return -1;
  }
  mbuffree(m);
  return len;
}
sockwrite
int
sockwrite(struct sock *si, uint64 addr, int n)
{
  struct proc *pr = myproc();
  struct mbuf *m;

  m = mbufalloc(MBUF_DEFAULT_HEADROOM);
  if (!m)
    return -1;

  if (copyin(pr->pagetable, mbufput(m, n), addr, n) == -1) {
    mbuffree(m);
    return -1;
  }
  net_tx_udp(m, si->raddr, si->lport, si->rport);
  return n;
}
lwip 移植大概概念
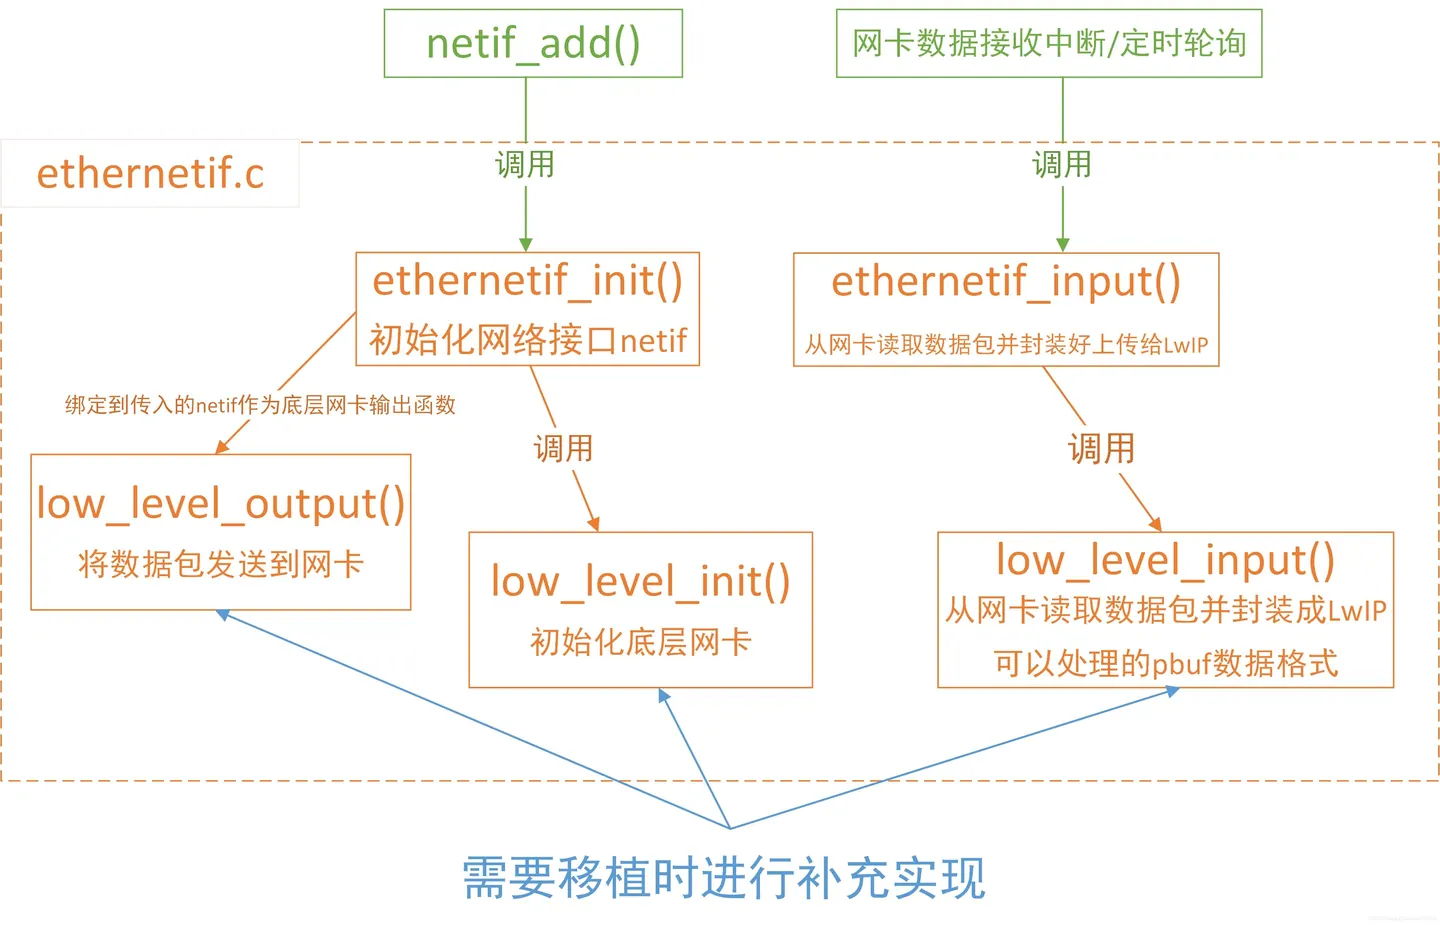
https://codinglover.top/2021/06/26/lwip%E5%BA%94%E7%94%A8%E7%AC%94%E8%AE%B0%EF%BC%88%E4%B8%80%EF%BC%89%EF%BC%9Alwip%E7%A7%BB%E6%A4%8D%E7%9A%84%E4%B8%80%E4%BA%9B%E9%A2%84%E5%A4%87%E7%9F%A5%E8%AF%86/ 上面是lwip 移植到一個 os
就拿 sockwrite 來說 他會走net_tx_udp跟這張圖做對比可以把他想成不斷的對我們的data 段,進行 ip header 的封裝
net_tx_udp
// sends a UDP packet
void
net_tx_udp(struct mbuf *m, uint32 dip,
           uint16 sport, uint16 dport)
{
  struct udp *udphdr;

  // put the UDP header
  udphdr = mbufpushhdr(m, *udphdr);
  udphdr->sport = htons(sport);
  udphdr->dport = htons(dport);
  udphdr->ulen = htons(m->len);
  udphdr->sum = 0; // zero means no checksum is provided

  // now on to the IP layer
  net_tx_ip(m, IPPROTO_UDP, dip);
}
net_tx_ip
// sends an IP packet
static void
net_tx_ip(struct mbuf *m, uint8 proto, uint32 dip)
{
  struct ip *iphdr;

  // push the IP header
  iphdr = mbufpushhdr(m, *iphdr);
  memset(iphdr, 0, sizeof(*iphdr));
  iphdr->ip_vhl = (4 << 4) | (20 >> 2);
  iphdr->ip_p = proto;
  iphdr->ip_src = htonl(local_ip);
  iphdr->ip_dst = htonl(dip);
  iphdr->ip_len = htons(m->len);
  iphdr->ip_ttl = 100;
  iphdr->ip_sum = in_cksum((unsigned char *)iphdr, sizeof(*iphdr));

  // now on to the ethernet layer
  net_tx_eth(m, ETHTYPE_IP);
}
net_tx_eth
static void
net_tx_eth(struct mbuf *m, uint16 ethtype)
{
  struct eth *ethhdr;

  ethhdr = mbufpushhdr(m, *ethhdr);
  memmove(ethhdr->shost, local_mac, ETHADDR_LEN);
  // In a real networking stack, dhost would be set to the address discovered
  // through ARP. Because we don't support enough of the ARP protocol, set it
  // to broadcast instead.
  memmove(ethhdr->dhost, broadcast_mac, ETHADDR_LEN);
  ethhdr->type = htons(ethtype);
  if (e1000_transmit(m)) {
    mbuffree(m);
  }
}
可以看到fucntion 最後還是透過 e1000_transmit 去送出一個packet
到此就是比較完整的一個trace,以這個LAB 來說完成的可能頂多算點對點,要完成 SERVER 的話可能進一步的了解SOCKET
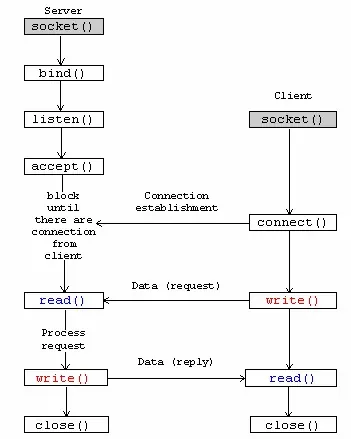 目前在看這一塊,bind 我想大概就是去監控 sockets 看要用polling 方式去定時查recv 的 packet,當發生有資料進來的時候,在去看bind 查到有沒有對應的端口, listen 看端口有沒有在監聽,有的會就accept 到這邊的話可能要結合一些tcp 的概念,當然要實現一些自定義的通訊協定也可以,粗略的lab 6 概念大概是這樣。
References
- Russ Cox, Frans Kaashoek, Robert Morris, xv6: a simple, Unix-like teaching operating system, MIT PDOS.
- MIT PDOS / xv6-riscv — 本文分析的 RISC-V xv6 實作與 lab 原始碼。
Comments